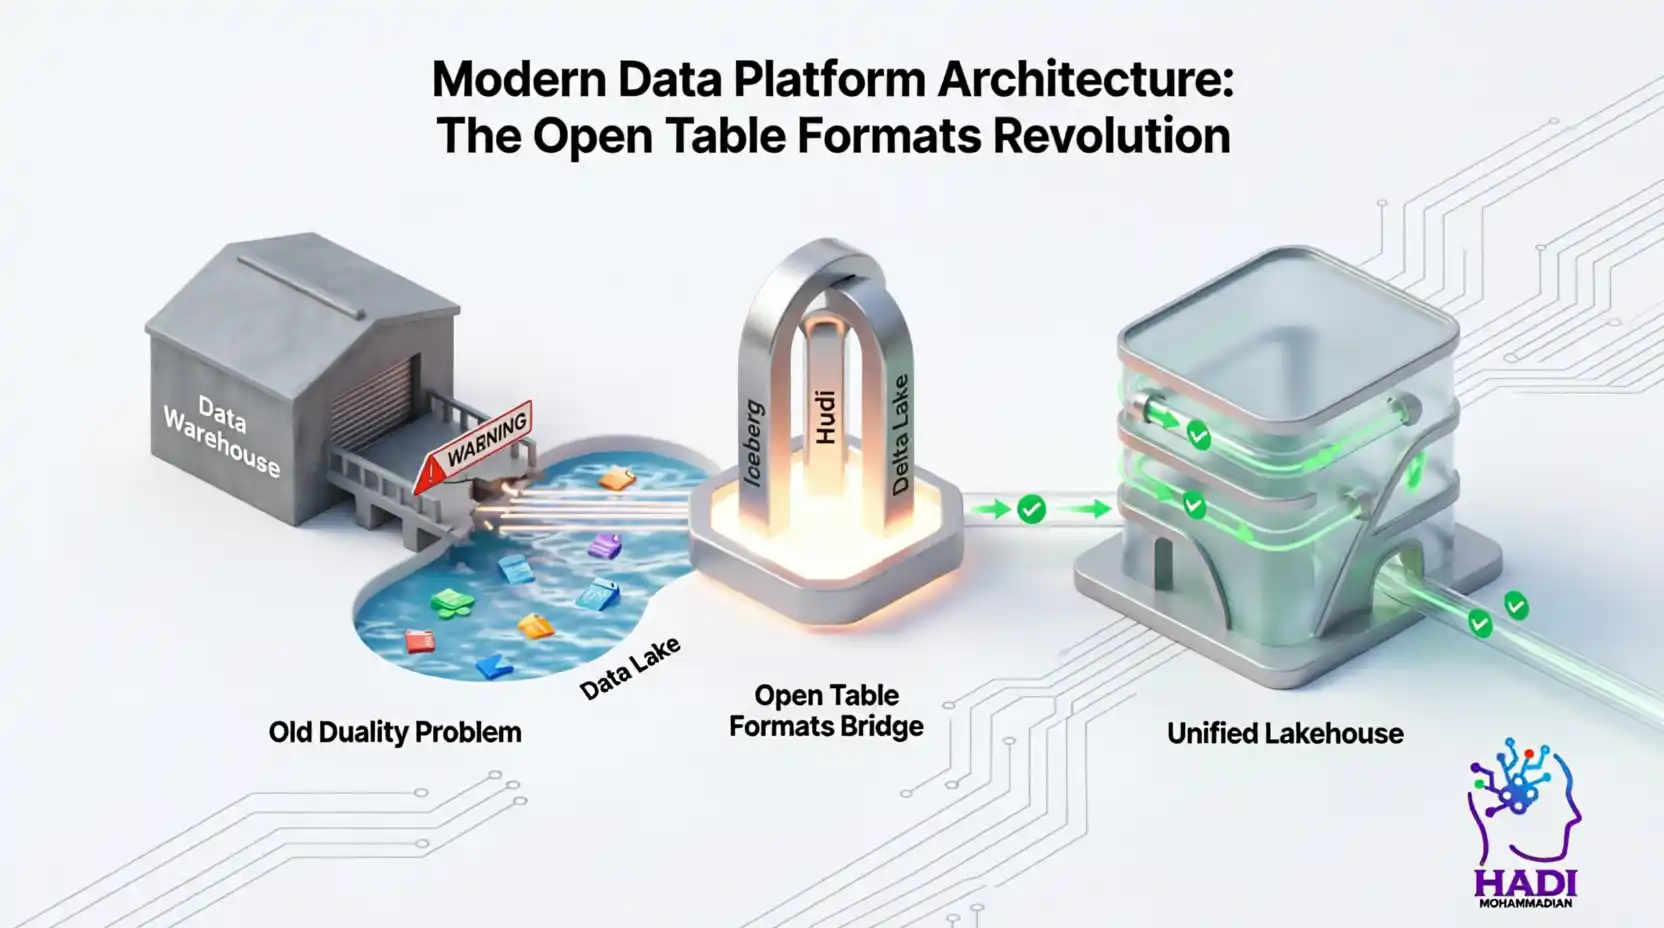
معماری پلتفرم داده مدرن: انقلاب Open Table Formats (Apache Iceberg, Apache Hudi, Delta Lake)
🔴 بخش ۱: مقدمه – بحران در دریاچههای داده و تولد معماری Lakehouse با Open Table Formats
در دهه گذشته، سازمانها با یک دوگانگی بزرگ روبرو بودند: انتخاب بین انبار داده (Data Warehouse) و دریاچه داده (Data Lake). Open Table Formats دقیقاً برای حل این دوگانگی ظهور کردهاند.
📊 مقایسه جامع انبار داده و دریاچه داده در عصر Open Table Formats
| ویژگی | 🏢 انبار داده (DATA WAREHOUSE) | 🌊 دریاچه داده (DATA LAKE) |
|---|---|---|
| نمونهها | Teradata, Snowflake, Oracle Exadata | Hadoop HDFS, AWS S3, Azure Data Lake |
| ساختار داده | ساختارمند (Structured) | هر نوع داده (JSON, Logs, XML, تصاویر) |
| تراکنش (ACID) | ✅ دارد | ❌ ندارد (تا قبل از Open Table Formats) |
| کیفیت داده | بالا (Schema Enforcement) | متغیر — تبدیل به «باتلاق داده» (Data Swamp) |
| سرعت کوئری | عالی (بهینهسازی شده برای OLAP) | متغیر (وابسته به موتور پردازشی) |
| هزینه | 💰💰💰 بسیار گران | 💰 ارزان (ذخیرهسازی ابری) |
| مقیاسپذیری | محدود (Scale-Up) | نامحدود (Scale-Out) |
| مناسب برای AI/ML | محدود | عالی |
⚠️ مشکل اصلی دریاچههای داده سنتی قبل از Open Table Formats
فایلهای Parquet یا Avro به خودی خود هیچ مفهومی از «تراکنش» نداشتند. اگر در حین نوشتن یک فایل ۱۰۰ گیگابایتی، فرآیند قطع میشد، فایل خراب باقی میماند. آپدیت کردن یک رکورد خاص عملاً غیرممکن بود. Open Table Formats این مشکلات را حل کردند.
💡 راهحل: معماری Lakehouse با Open Table Formats
معماری Lakehouse برای حل این شکاف متولد شد: آوردن قابلیتهای انبار داده (ACID, Schema Enforcement, Time Travel) روی فضای ذخیرهسازی ارزان دریاچه داده (S3/ADLS). کلید این معماری، Open Table Formats هستند که یک لایه انتزاعی بین فایلهای فیزیکی (Parquet) و موتور پردازشی (Spark/Trino) ایجاد میکنند.
🔑 نکته کلیدی: Lakehouse یعنی بهترینهای هر دو دنیا — هزینه پایین Data Lake + قابلیتهای ACID و مدیریتی Data Warehouse. Open Table Formats این ترکیب را ممکن میسازند.
🟠 بخش ۲: تشریح فنی – Open Table Formats (OTF) دقیقاً چیست؟
بسیاری از مهندسان داده، فرمت فایل (File Format) را با فرمت جدول (Table Format) اشتباه میگیرند. Open Table Formats لایهای متفاوت و حیاتی هستند.
📋 تفاوت فرمت فایل و Open Table Formats
| مفهوم | توضیح | مثالها | سطح |
|---|---|---|---|
| فرمت فایل (File Format) | نحوه ذخیره بایتها در یک فایل | Parquet, ORC, Avro | فیزیکی |
| فرمت جدول (Table Format) | مجموعهای از فایلها به عنوان یک «جدول» با متادیتای غنی | Iceberg, Delta, Hudi | منطقی |
🔍 Open Table Formats در واقع یک لایه فراداده (Metadata Layer) هوشمند هستند
این لایه به سوالات زیر پاسخ میدهد:
| # | سوال | قابلیت Open Table Formats |
|---|---|---|
| ۱ | کدام فایلهای Parquet در S3 متعلق به جدول Sales هستند؟ | File Tracking |
| ۲ | وضعیت جدول در ساعت ۱۰ صبح دیروز چگونه بود؟ | Time Travel |
| ۳ | آیا این تراکنش نوشتن تمام شده است یا ناقص است؟ | ACID Transactions |
| ۴ | چگونه میتوانم بدون بازنویسی کل جدول، یک ستون را تغییر نام دهم؟ | Schema Evolution |
| ۵ | کدام فایلها را باید برای این کوئری خاص بخوانم؟ | Partition Pruning |
🔄 تحول از Hive Metastore به Open Table Formats مدرن
| جنبه | HIVE METASTORE (سنتی) | Open Table Formats (ICEBERG/DELTA/HUDI) |
|---|---|---|
| محل ذخیره متادیتا | دیتابیس متمرکز (MySQL/Postgres) | کنار خودِ دادهها روی فایل سیستم |
| مقیاسپذیری | گلوگاه (Bottleneck) | بینهایت |
| تکامل اسکیما | بسیار محدود | کامل |
| Time Travel | ندارد | دارد |
| ACID | محدود | کامل |
⚡ نکته کلیدی: در Open Table Formats مدرن، متادیتای جدول در کنار خودِ دادهها ذخیره میشود و مقیاسپذیری بینهایت را ممکن میسازد.
🟡 بخش ۳: کالبدشکافی سه غول بزرگ Open Table Formats – Iceberg، Hudi و Delta
الف) Apache Iceberg: معماری مدرن و استاندارد باز در Open Table Formats 🧊
آیسبرگ توسط Netflix توسعه یافت تا مشکل لیست کردن میلیونها فایل در S3 را حل کند. این یکی از محبوبترین Open Table Formats است.
⭐ ویژگی کلیدی: Hidden Partitioning در Open Table Formats
| جنبه | HIVE قدیمی | ICEBERG |
|---|---|---|
| روش | ساخت ستون جداگانه day و نوشتن WHERE day = ... | پارتیشن بر اساس TRUNCATE(timestamp, 'day') |
| مشکل | اگر کاربر روی timestamp فیلتر میکرد، کل جدول اسکن میشد | کاربر روی همان ستون timestamp کوئری میزند |
| نتیجه | گلوگاه عملکرد | Partition Pruning خودکار |
| نیاز به ستون کمکی | ✅ بله | ❌ خیر |
🔄 تکامل اسکیما در Open Table Formats
آیسبرگ از ID برای ستونها استفاده میکند، نه نام. بنابراین تغییر نام ستون، تغییر نوع داده، تغییر ترتیب ستونها و افزودن/حذف ستون بدون بازنویسی کل جدول انجام میشود.
🏗️ معماری سه لایه متادیتا در Open Table Formats
| لایه | توضیح | نقش |
|---|---|---|
| ۱. Snapshots | وضعیت کل جدول در یک لحظه | Time Travel |
| ۲. Manifest Lists | لیست فایلهای Manifest متعلق به یک اسنپشات | سازماندهی |
| ۳. Manifest Files | لیست دقیق فایلهای داده (Parquet) با آمار (Min/Max) | Data Skipping |
ب) Apache Hudi: پادشاه استریمینگ در Open Table Formats 👑
هودی توسط Uber برای مدیریت پتابایتها داده سفر طراحی شد. تمرکز اصلی روی Upsert بسیار سریع است. این یکی از قدرتمندترین Open Table Formats برای استریمینگ است.
⭐ ویژگی کلیدی: ایندکسگذاری در Open Table Formats
| نوع ایندکس | توضیح | کاربرد |
|---|---|---|
| Bloom Filter | ساختار داده احتمالاتی برای تست عضویت سریع | تشخیص سریع وجود رکورد |
| HBase Index | ایندکس خارجی در HBase | مقیاسهای بسیار عظیم |
| Simple Index | ایندکس ساده در حافظه | جداول کوچک |
مزیت: عملیات آپدیت بسیار سریعتر از Iceberg یا Delta در مقیاسهای عظیم
📅 Timeline در Open Table Formats
هسته مرکزی Hudi یک تایملاین است که تمام اقدامات را ثبت میکند:
| اقدام | توضیح |
|---|---|
| Commit | ثبت یک نوشتن کامل |
| Delta Commit | ثبت تغییرات تدریجی |
| Rollback | بازگشت به حالت قبلی |
| Compaction | ادغام فایلهای کوچک |
| Cleaning | حذف فایلهای قدیمی |
ج) Delta Lake: پرفورمنس و اکوسیستم Databricks در Open Table Formats ⚡
دلتا لیک توسط بنیانگذاران Spark در Databricks ساخته شد. این یکی از بالغترین Open Table Formats است.
⭐ ویژگی کلیدی: Transaction Log در Open Table Formats
| جنبه | توضیح |
|---|---|
| فرمت | فایلهای JSON + Checkpoint (Parquet) |
| مزیت | پروتکل ساده و قابل درک |
| عملکرد | ثبت تمام تراکنشها به ترتیب |
📐 Z-Ordering در Open Table Formats
اولین پلتفرم با الگوریتم مرتبسازی Z-Order. پرش از روی دادهها (Data Skipping) در فایلهای چندبعدی و افزایش شدید سرعت کوئریها.
🔗 UniForm در Open Table Formats
اجازه میدهد جداول Delta به طور خودکار به عنوان Iceberg یا Hudi نیز خوانده شوند. حذف Vendor Lock-in. یک فایل فیزیکی، چند فرمت منطقی.
برای مطالعه بیشتر درباره Apache Iceberg، مستندات رسمی Apache Iceberg را ببینید.
مقاله داخلی ما با عنوان «Hidden Partitioning در Iceberg» را مطالعه کنید.
🟢 بخش ۴: مقایسه معماری و فنی Open Table Formats (Deep Dive)
📊 جدول مقایسه جامع Open Table Formats
| ویژگی | 🧊 APACHE ICEBERG | 👑 APACHE HUDI | ⚡ DELTA LAKE |
|---|---|---|---|
| خاستگاه | Netflix (اصلاح متادیتای Hive) | Uber (Upsert و Ingestion) | Databricks (جایگزینی انبار داده) |
| سال انتشار | ۲۰۱۷ | ۲۰۱۶ | ۲۰۱۹ |
| تکنیک آپدیت (DML) | Merge-on-Read & Copy-on-Write | تمرکز قوی بر MoR، پشتیبانی از CoW | عمدتاً CoW (پشتیبانی از MoR در نسخههای جدید) |
| پارتیشنبندی | ⭐ Hidden Partitioning (بهترین در کلاس) | پارتیشنبندی فیزیکی صریح | پارتیشنبندی فیزیکی صریح |
| تکامل اسکیما | ⭐ Full Schema Evolution | محدودتر | پشتیبانی خوب |
| Performance | عالی برای کوئریهای تحلیلی سنگین | عالی برای نوشتن (Write) و تغییرات زیاد (CDC) | عالی برای کوئریهای تعاملی |
| اکوسیستم | ⭐ بسیار باز (AWS, Snowflake, Trino, Google) | پیچیدگی بالا | پیشفرض در Databricks/Azure/Fabric |
| زبانهای پشتیبانی | Java, Python, Scala, Spark, Flink, Trino | Java, Spark, Flink, Kafka | Spark, Python, SQL |
| جامعه (Community) | ⭐ بسیار فعال و متنوع | فعال | فعال (متمرکز بر Databricks) |
| پشتیبانی ابری | AWS, GCP, Azure | AWS, GCP, Azure | Databricks, Azure, AWS |
🔵 بخش ۵: معماری مرجع Open Table Formats (Reference Architecture)
یک پلتفرم داده مدرن مبتنی بر Open Table Formats دارای ۵ لایه اصلی است:
🏗️ نمای کلی معماری Open Table Formats
| لایه | ابزارها | وظیفه |
|---|---|---|
| ۱. اینجکشن | Kafka Connect, Flink, Spark Streaming | دریافت دادههای خام |
| ۲. ذخیرهسازی | S3, ADLS Gen2, GCS, MinIO | نگهداری فایلهای Parquet/Avro |
| ۳. فرمت جدول | Iceberg / Hudi / Delta | مدیریت متادیتا و تراکنشها |
| ۴. کاتالوگ | AWS Glue, Hive Metastore, Nessie, Unity Catalog | مکانیابی آخرین متادیتا |
| ۵. پردازش | Spark, Flink, Trino, Dremio | خواندن و نوشتن داده |
۱. لایه اینجکشن (Ingestion Layer) در Open Table Formats 📥
ابزارها: Kafka Connect, Flink, Spark Structured Streaming
وظیفه: دریافت دادههای خام از دیتابیسهای عملیاتی (CDC logs) و IoT
۲. لایه ذخیرهسازی (Storage Layer) در Open Table Formats 💾
ابزارها: Amazon S3, Azure Data Lake Gen2, Google GCS, MinIO (On-prem)
فرمت: فایلهای Parquet یا Avro
۳. لایه فرمت جدول (Table Format Layer) در Open Table Formats 📋
ابزارها: Iceberg / Hudi / Delta
وظیفه: مدیریت متادیتا، تراکنشها و فایلها
ارزش: افزودن ACID و Time Travel به Data Lake
۴. لایه کاتالوگ (Catalog Layer) در Open Table Formats ⚠️ حیاتی
Open Table Formats نیاز به یک کاتالوگ دارند تا بگویند «آخرین نسخه فایل متادیتا کجاست؟»
گزینهها: AWS Glue، Hive Metastore، Project Nessie، Unity Catalog
۵. لایه پردازش (Compute Engine) در Open Table Formats ⚙️
نوشتن: Spark, Flink
خواندن/تحلیل: Trino (PrestoSQL), Starburst, Dremio, Spark SQL, Snowflake (External Tables)
🟣 بخش ۶: سناریوی عملیاتی گامبهگام Open Table Formats – پیادهسازی پایپلاین CDC
📋 سناریو: مهندس داده در یک شرکت تجارت الکترونیک بزرگ هستید. باید تغییرات جدول Orders را از PostgreSQL دریافت کرده و در Lakehouse اعمال کنید.
راهحل: استفاده از Apache Iceberg (یکی از Open Table Formats) و Spark
🎯 گام ۱: پیکربندی محیط (Spark Session) در Open Table Formats
from pyspark.sql import SparkSession

spark = SparkSession.builder \
    .appName("Iceberg CDC Pipeline") \
    .config("spark.jars.packages", "org.apache.iceberg:iceberg-spark-runtime-3.5_2.12:1.4.2") \
    .config("spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions") \
    .config("spark.sql.catalog.my_catalog", "org.apache.iceberg.spark.SparkCatalog") \
    .config("spark.sql.catalog.my_catalog.type", "hive") \
    .config("spark.sql.catalog.my_catalog.uri", "thrift://metastore:9083") \
    .config("spark.sql.catalog.my_catalog.warehouse", "s3a://warehouse/path") \
    .getOrCreate()
🎯 گام ۲: ایجاد جدول پایه (DDL) در Open Table Formats
CREATE TABLE my_catalog.sales.orders ( order_id BIGINT, customer_id BIGINT, amount DECIMAL(10, 2), order_status STRING, created_at TIMESTAMP, updated_at TIMESTAMP ) USING iceberg PARTITIONED BY (days(created_at)); -- پارتیشنبندی مخفی بر اساس روز
🎯 گام ۳: خواندن دادههای CDC در Open Table Formats
دادههای CDC را به صورت دورهای از Kafka میخوانیم. این دیتافریم شامل ستونهای op_type (I/U/D)، order_id و updated_at است.
🎯 گام ۴: عملیات MERGE INTO در Open Table Formats (قلب تپنده Lakehouse)
# ایجاد یک View موقت از دادههای جدید cdc_df.createOrReplaceTempView("cdc_updates") # اجرای کوئری Merge spark.sql(""" MERGE INTO my_catalog.sales.orders AS target USING ( SELECT * FROM ( SELECT *, ROW_NUMBER() OVER (PARTITION BY order_id ORDER BY updated_at DESC) as rn FROM cdc_updates ) WHERE rn = 1 -- فقط آخرین نسخه هر سفارش را بردار (Deduplication) ) AS source ON target.order_id = source.order_id WHEN MATCHED AND source.op_type = 'U' THEN UPDATE SET target.amount = source.amount, target.order_status = source.order_status, target.updated_at = source.updated_at WHEN MATCHED AND source.op_type = 'D' THEN DELETE WHEN NOT MATCHED AND source.op_type = 'I' THEN INSERT (order_id, customer_id, amount, order_status, created_at, updated_at) VALUES (source.order_id, source.customer_id, source.amount, source.order_status, source.created_at, source.updated_at) """)
✨ جادوی Open Table Formats: به جای بازنویسی پارتیشنها، فقط رکوردهای تغییر کرده اعمال میشوند
🎯 گام ۵: Time Travel در Open Table Formats ⏰
-- با استفاده از Timestamp
SELECT * FROM my_catalog.sales.orders
TIMESTAMP AS OF '2023-10-27 08:00:00'
WHERE order_id = 100;

-- با استفاده از Snapshot ID
SELECT * FROM my_catalog.sales.orders
VERSION AS OF 1234567890123456789
WHERE order_id = 100;
✨ این قابلیت بدون نیاز به کپیهای جداگانه، تنها با استفاده از Snapshot IDها در متادیتای Open Table Formats انجام میشود.
🟤 بخش ۷: مکانیسمهای داخلی – CoW در برابر MoR در Open Table Formats
درک تفاوت Copy-on-Write (CoW) و Merge-on-Read (MoR) در Open Table Formats برای یک معمار حیاتی است.
📊 مقایسه CoW و MoR در Open Table Formats
| جنبه | COPY-ON-WRITE (COW) | MERGE-ON-READ (MOR) |
|---|---|---|
| نحوه کار | کل فایل خوانده شده، رکورد تغییر میکند، فایل جدید نوشته میشود | فایل اصلی دست نمیخورد، تغییرات در فایل لاگ (Avro) نوشته میشود |
| سرعت خواندن | ⭐ بسیار بالا | پایینتر (نیاز به ترکیب در لحظه) |
| سرعت نوشتن | پایین (Write Amplification) | ⭐ بسیار بالا |
| مصرف فضای ذخیرهسازی | بیشتر (بازنویسی کامل) | کمتر (فقط لاگها) |
| کاربرد | جداول Dimension با خواندن زیاد | جداول استریمینگ با نوشتن بالا |
| نیاز به Compaction | خیر | ✅ بله |
⚠️ نکته: Iceberg و Hudi هر دو از این قابلیت پشتیبانی میکنند. برای حفظ پرفورمنس MoR، نیاز به فرآیندی به نام Compaction داریم.
⚫ بخش ۸: استراتژیهای بهینهسازی و نگهداری در Open Table Formats
بدون نگهداری، جداول Open Table Formats به مرور زمان کند میشوند (مشکل فایلهای کوچک یا Small Files Problem).
۱. فشردهسازی (Compaction / Bin-packing) در Open Table Formats 📦
| جنبه | توضیح |
|---|---|
| هدف | ادغام فایلهای کوچک در فایلهای بزرگتر (۱۲۸ یا ۲۵۶ مگابایت) |
| در Iceberg | پروسیجر rewrite_data_files |
| در Hudi | سرویس Compaction (قابل اجرا Async) |
| در Delta | دستور OPTIMIZE |
۲. مرتبسازی چندبعدی (Z-Ordering / Hilbert Curve) در Open Table Formats 📐
| جنبه | توضیح |
|---|---|
| مشکل | مرتبسازی ساده (ORDER BY x) فقط روی یک ستون خوب کار میکند |
| راهحل | Z-Order دادههای چندبعدی را به یک بُعد تبدیل میکند |
| نتیجه | دادههای مرتبط در دیسک کنار هم قرار میگیرند |
| مزیت | Data Skipping — موتور کوئری از خواندن بخشهای بزرگ صرفنظر میکند |
۳. مدیریت اسنپشاتها (Snapshot Expiration / Vacuum) در Open Table Formats 🗑️
| جنبه | توضیح |
|---|---|
| مشکل | هر تراکنش یک نسخه جدید ایجاد میکند |
| دستور | VACUUM (در Delta) یا expire_snapshots (در Iceberg) |
| عملکرد | حذف فایلهای قدیمیتر از زمان مشخص (مثلاً ۷ روز) |
| ⚠️ هشدار | بعد از این کار، Time Travel به قبل از آن تاریخ ممکن نیست |
⚪ بخش ۹: چالش کاتالوگها و آینده Interoperability در Open Table Formats
🔥 جنگ کاتالوگها در Open Table Formats
| شرکت | کاتالوگ | استراتژی |
|---|---|---|
| Databricks | Unity Catalog | اکوسیستم بسته |
| Snowflake | کاتالوگ اختصاصی | Vendor Lock-in |
| AWS | Glue | استاندارد ابری |
🚀 راهحلهای آینده در Open Table Formats
۱. پروژه UniForm (توسط Databricks): داده یک بار به فرمت Delta نوشته میشود. سیستم به طور خودکار متادیتای Iceberg و Hudi را هم تولید میکند. یک فایل فیزیکی، همزمان برای ابزارهای مختلف قابل خواندن است.
۲. پروژه Apache XTable: لایه ترجمه omni-directional. تبدیل فرمتهای مختلف بدون کپی داده. فقط ترجمه متادیتا.
۳. کاتالوگهای REST (Project Nessie): شبیه Git عمل میکنند. قابلیت Branching, Tagging, Merging روی دادهها. آینده DataOps.
🔮 تصور کنید: یک برنچ dev از دیتای پروداکشن بسازید، تست کنید و سپس merge کنید!
برای مطالعه بیشتر درباره Project Nessie، مستندات Project Nessie را ببینید.
✅ بخش ۱۰: نتیجهگیری و توصیههای نهایی در Open Table Formats
مهاجرت به معماری مبتنی بر Open Table Formats دیگر یک انتخاب لوکس نیست، بلکه یک ضرورت برای سازمانهایی است که میخواهند از هوش مصنوعی و تحلیلهای پیشرفته استفاده کنند.
📌 راهنمای انتخاب Open Table Formats
| شرایط | انتخاب پیشنهادی | دلیل |
|---|---|---|
| کاربر سنگین Databricks | Delta Lake | یکپارچگی طبیعی |
| استاندارد کاملاً باز | Apache Iceberg ⭐ | حمایت Netflix، Apple، AWS |
| استریمینگ سنگین | Apache Hudi | Upsert سریع و CDC |
🎯 توصیه نهایی به معماران در Open Table Formats
روی جداسازی لایه محاسبات (Compute) از لایه ذخیرهسازی (Storage) تمرکز کنید
از Open Table Formats استفاده کنید تا دچار Vendor Lock-in نشوید
دادههای شما ارزشمندترین دارایی هستند؛ آنها را در فرمتهای اختصاصی حبس نکنید
معماری خود را بر اساس Iceberg یا Delta بنا کنید
از آزادی انتخاب موتور پردازشی (امروز Spark، فردا Trino، پسفردا؟) لذت ببرید