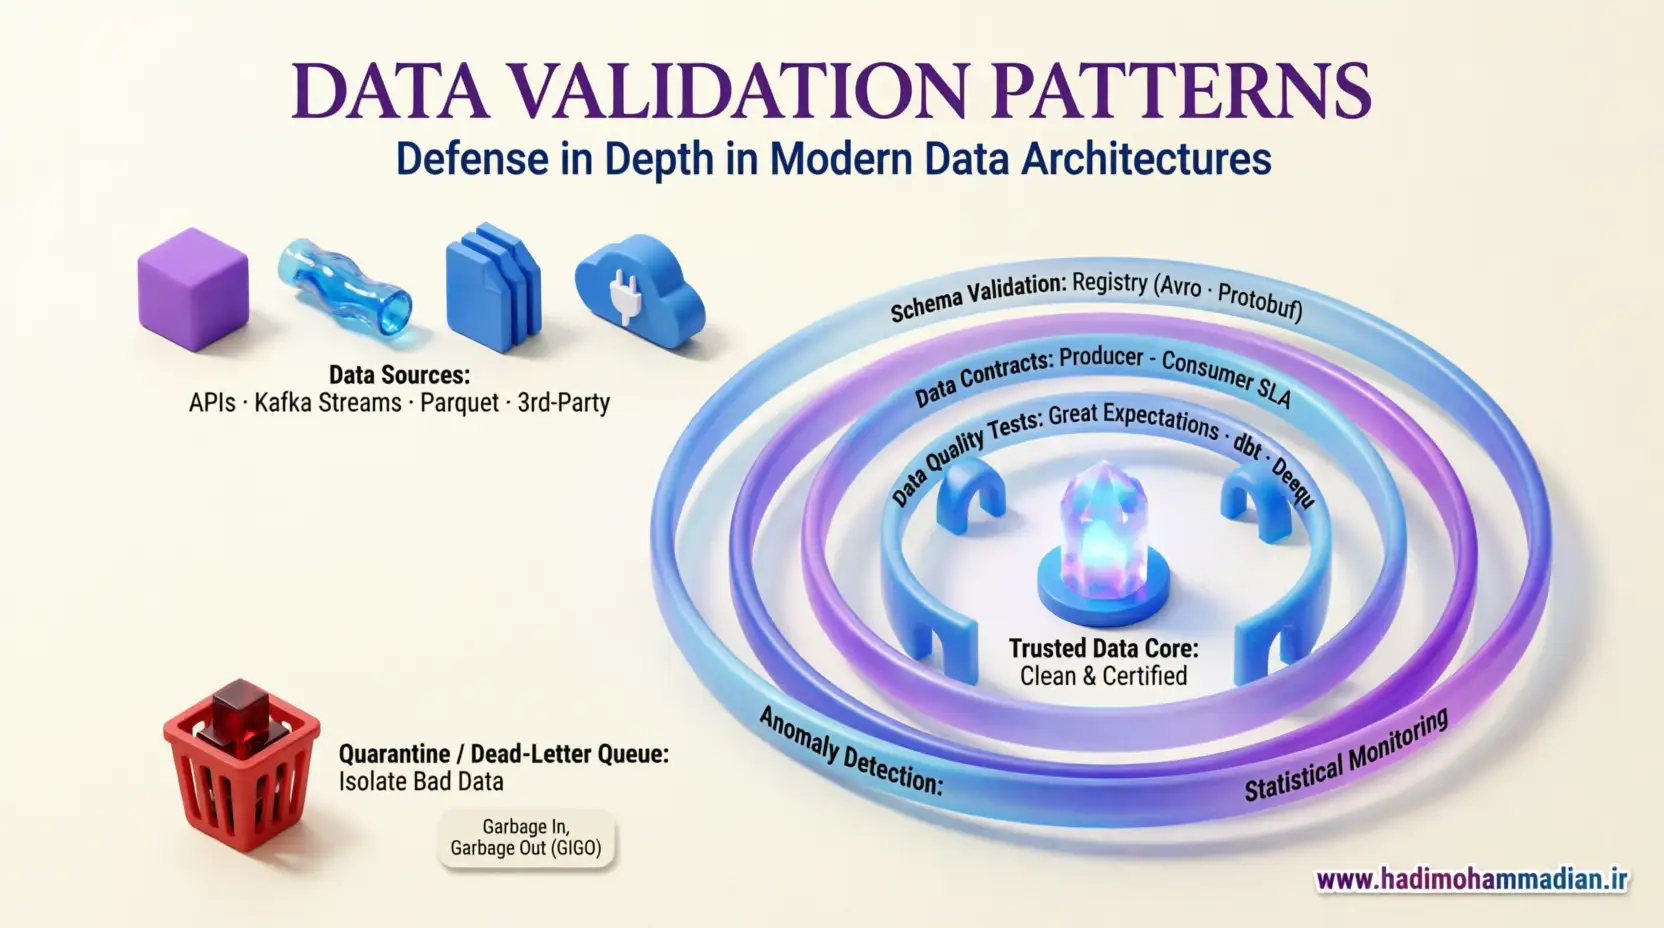
الگوهای Data Validation: استراتژی «دفاع در عمق» در معماریهای مدرن داده
🔴 بخش ۱: مقدمه – فراتر از «زباله در برابر زباله» در الگوهای Data Validation
اصل قدیمی «Garbage In, Garbage Out» (GIGO) همچنان معتبر است، اما در معماریهای مدرن و توزیعشده (مانند Data Mesh یا Microservices)، مدیریت «زباله» بسیار پیچیدهتر شده است. در یک سیستم یکپارچه قدیمی، شاید یک قید (Constraint) در دیتابیس SQL کافی بود. اما در سیستمهایی که دادهها از APIها، جریانهای Kafka، فایلهای Parquet و سیستمهای شخص ثالث سرازیر میشوند، تکیه بر یک نقطه اعتبارسنجی واحد، خودکشی مهندسی است. الگوهای Data Validation دقیقاً برای حل این چالش طراحی شدهاند.
این تغییر پارادایم نتیجه تنوع منابع داده و پیچیدگی معماریهای مدرن است. در گذشته، دادهها از مسیر مشخصی وارد سیستم میشدند و یک نقطه کنترل کافی بود. اما امروزه، دادهها از دهها منبع مختلف با فرمتهای متفاوت وارد میشوند و هر منبع ممکن است کیفیت متفاوتی داشته باشد.
رویکرد مدرن، «دفاع در عمق» (Defense in Depth) نام دارد. همانطور که در امنیت سایبری چندین لایه دفاعی (فایروال، احراز هویت، رمزنگاری) داریم، در مهندسی داده نیز باید در هر لایه از معماری (Ingestion, Processing, Storage, Serving) فیلترهای اعتبارسنجی خاص آن لایه را اعمال کنیم. الگوهای Data Validation این فیلترها را در تمام لایهها پیادهسازی میکنند.
🔑 نکته کلیدی: هزینه اصلاح داده در لایه Ingestion بسیار کمتر از هزینه اصلاح تصمیمات غلط مدیران در لایه Consumption است. الگوهای Data Validation یک «تیک» نیستند که در پایان پروژه زده شوند، بلکه فرآیندی مستمر در کل چرخه حیات داده هستند.
🟠 بخش ۲: لایه اول – ورودی و پذیرش (Ingestion Layer) در الگوهای Data Validation
این اولین خط دفاعی در الگوهای Data Validation است. هدف در اینجا «Fail Fast» (شکست سریع) است. اگر دادهای از نظر ساختاری اشتباه است، نباید اجازه ورود به سیستم را داشته باشد و منابع پردازشی پاییندست را هدر دهد.
📊 نوع اعتبارسنجی: ساختاری (Syntactic & Structural) در الگوهای Data Validation
در این لایه، ما به «معنای» داده کاری نداریم، بلکه به «شکل» آن کار داریم.
| نوع بررسی | توضیح | نمونه |
|---|---|---|
| 📝 Type Checking | آیا age عدد است؟ | age = "بیست" ❌ |
| 📋 Format Validation | آیا تاریخ طبق ISO 8601 است؟ | 2023-13-45 ❌ |
| 🔒 Schema Compliance | آیا با Avro/Protobuf مطابقت دارد؟ | فیلد گمشده ❌ |
🛠️ الگوهای پیادهسازی در الگوهای Data Validation
Schema-on-Write: در سیستمهای استریمینگ (مانند Kafka با Confluent Schema Registry)، تولیدکننده مجبور است داده را با یک اسکیمای ثبت شده سریالایز کند. اگر داده با اسکیما نخواند، SerializationException رخ داده و پیام اصلاً ارسال نمیشود. این یکی از قویترین الگوهای Data Validation در لایه ورودی است.
API Validation DTOs: در وبسرویسها، استفاده از کتابخانههایی مثل Pydantic (در پایتون) یا Bean Validation (در جاوا) برای رد کردن درخواستهای نامعتبر با خطای 400 Bad Request.
📊 جدول الگوهای Data Validation در لایه Ingestion
| الگو | ابزار | رفتار |
|---|---|---|
| 🔒 Schema-on-Write | Schema Registry | رد کامل پیام |
| 📝 DTO Validation | Pydantic, Bean Validation | خطای 400 |
| ⚡ Fail Fast | تمام موارد | توقف فوری |
مقاله داخلی ما با عنوان «Schema Registry در کافکا» را مطالعه کنید.
🟡 بخش ۳: لایه دوم – پردازش و تبدیل (Transformation Layer) در الگوهای Data Validation
وقتی داده وارد سیستم شد (مثلاً در Data Lake نشست)، مرحله پردازش (ETL/ELT) آغاز میشود. در اینجا الگوهای Data Validation پیچیدهتر و منطقی اعمال میشوند.
📊 نوع اعتبارسنجی: معنایی و کسبوکاری (Semantic & Business Logic) در الگوهای Data Validation
در این لایه، دادهها از نظر ساختاری سالم هستند، اما ممکن است از نظر «منطق کسبوکار» اشتباه باشند.
| نوع بررسی | توضیح | نمونه |
|---|---|---|
| 🔗 یکپارچگی ارجاعی | آیا user_id در جدول users وجود دارد؟ | یتیم ❌ |
| 📋 قوانین دامنه | start_date بعد از end_date نباشد | معکوس ❌ |
| 🧮 منطق بینرکوردی | مجموع اقلام = مبلغ کل فاکتور | نابرابری ❌ |
🛠️ الگوهای پیادهسازی در الگوهای Data Validation
الگوی قرنطینه (Quarantine / Dead Letter Queue): برخلاف لایه اول، در اینجا معمولاً نمیخواهیم کل پایپلاین Spark یا dbt را به خاطر چند رکورد خراب متوقف کنیم. الگوهای Data Validation در این لایه از DLQ استفاده میکنند.
| مسیر | مقصد | اقدام |
|---|---|---|
| ✅ سالم | مسیر اصلی | ادامه پردازش |
| ❌ نامعتبر | Error Table / DLQ | بررسی بعدی |
تستهای واحد داده (Data Unit Tests): استفاده از ابزارهایی مانند dbt tests یا Great Expectations در حین اجرای پایپلاین. اینها از محبوبترین الگوهای Data Validation در لایه پردازش هستند.
مثال:
expect_column_values_to_be_unique(order_id)
مقاله داخلی ما با عنوان «تست داده با Great Expectations» را مطالعه کنید.
🟢 بخش ۴: لایه سوم – ذخیرهسازی و انبار داده (Storage Layer) در الگوهای Data Validation
در این لایه، دادهها قرار است برای تحلیل نهایی ذخیره شوند (مثلاً در Snowflake یا BigQuery). اعتبارسنجی در این مرحله «آخرین سنگر» قبل از مصرف است. الگوهای Data Validation در این لایه بر یکپارچگی و قیود تمرکز دارند.
📊 نوع اعتبارسنجی: قیود و یکپارچگی (Constraints & Integrity) در الگوهای Data Validation
| نوع بررسی | توضیح |
|---|---|
| 🔒 قیود دیتابیس | NOT NULL، UNIQUE، PRIMARY KEY |
| 🔄 تشخیص تکرار | جلوگیری از Duplicate |
| ⏱️ تازگی داده | آیا دادهها مربوط به امروز هستند؟ |
🛠️ الگوهای پیادهسازی در الگوهای Data Validation
Audit Tables: جداولی که متادیتای بارگذاری (تعداد سطر ورودی، تعداد سطر خروجی، زمان اجرا) را ذخیره میکنند. اگر اختلاف تعداد سطر غیرعادی باشد، هشدار ارسال میشود. این یکی از ضروریترین الگوهای Data Validation برای ردیابی است.
Blue/Green Loading: دادهها ابتدا در یک جدول موقت (Staging) بارگذاری و اعتبارسنجی میشوند. اگر تستها پاس شد، با یک تراکنش اتمیک جایگزین جدول اصلی میشوند (Swap). این الگو از الگوهای Data Validation برای استقرار امن داده است.
برای مطالعه بیشتر درباره Soda، مستندات Soda را ببینید.
🔵 بخش ۵: لایه چهارم – مصرف و سرویسدهی (Consumption Layer) در الگوهای Data Validation
حتی اگر تمام لایههای قبلی درست کار کنند، ممکن است دادهها به شکلی ترکیب شوند که برای مصرفکننده نهایی «عجیب» باشند. الگوهای Data Validation در این لایه بر ناهنجاری و توزیع تمرکز دارند.
📊 نوع اعتبارسنجی: ناهنجاری و توزیع (Anomaly & Distribution) در الگوهای Data Validation
| نوع بررسی | توضیح |
|---|---|
| 📊 Data Drift | تغییر توزیع آماری دادهها |
| 📉 Aggregate Checks | افت ناگهانی ۹۰٪ در فروش |
🛠️ الگوهای پیادهسازی در الگوهای Data Validation
Circuit Breakers: اگر داشبورد مدیریتی اعداد پرت نمایش میدهد، بهتر است اصلاً نشان ندهد. ابزارهای BI یا لایه سرویس میتوانند اگر متریکها از آستانه (Threshold) خاصی عبور کردند، دسترسی را قطع کنند. این الگو از الگوهای Data Validation برای محافظت از کاربر نهایی است.
Observability Monitors: ابزارهایی مانند Monte Carlo که به طور مداوم الگوهای آماری خروجی نهایی را رصد میکنند.
برای مطالعه بیشتر درباره Evidently AI، مستندات Evidently AI را ببینید.
مقاله داخلی ما با عنوان «نظارت بر کیفیت داده در تولید» را مطالعه کنید.
🟣 بخش ۶: خلاصه – ماتریس الگوهای Data Validation
📊 جدول جامع ماتریس الگوهای Data Validation
| لایه | نوع داده | تمرکز | ابزارها | الگوی اصلی |
|---|---|---|---|---|
| 📥 Ingestion | Raw/JSON | سینتکس، اسکیما | Avro, Pydantic | Fail Fast |
| 🔄 Processing | Tabular/Streams | منطق بیزنس | Great Expectations, dbt | Quarantine |
| 💾 Storage | Relational/OLAP | قیود، یکتایی | SQL Constraints, Soda | Audit & Alert |
| 🖥️ Consumption | Aggregated | توزیع آماری | Evidently AI | Circuit Breaker |
📊 جدول مقایسه الگوهای Data Validation
| الگو | لایه | مزیت | چالش |
|---|---|---|---|
| ⚡ Fail Fast | Ingestion | جلوگیری زودهنگام | ممکن است بیش از حد سختگیر باشد |
| 🔒 Quarantine | Processing | توقف نکردن پایپلاین | نیاز به مدیریت DLQ |
| 📊 Audit | Storage | ردیابی کامل | سربار ذخیرهسازی |
| 🛡️ Circuit Breaker | Consumption | محافظت از کاربر | پیچیدگی پیادهسازی |
✅ بخش ۷: نتیجهگیری – چکلیست نهایی الگوهای Data Validation
الگوهای Data Validation یک «تیک» نیستند که در پایان پروژه زده شوند. این یک فرآیند مستمر است که باید در تار و پود معماری تنیده شود.
📌 اصول کلیدی موفقیت در الگوهای Data Validation
| اصل | توضیح |
|---|---|
| 🛡️ دفاع در عمق | اعتبارسنجی در هر لایه |
| ⚡ Fail Fast | شکست سریع در ورودی |
| 🔒 قرنطینه | جداسازی دادههای خراب |
| 📊 نظارت مداوم | پایش توزیع و ناهنجاری |
💡 پیام نهایی: با پیادهسازی استراتژی دفاع در عمق از طریق الگوهای Data Validation، شما نه تنها از ورود دادههای خراب جلوگیری میکنید، بلکه اعتماد سازمان به دادهها را تضمین میکنید. به یاد داشته باشید: هزینه اصلاح داده در لایه Ingestion بسیار کمتر از هزینه اصلاح تصمیمات غلط مدیران در لایه Consumption است.