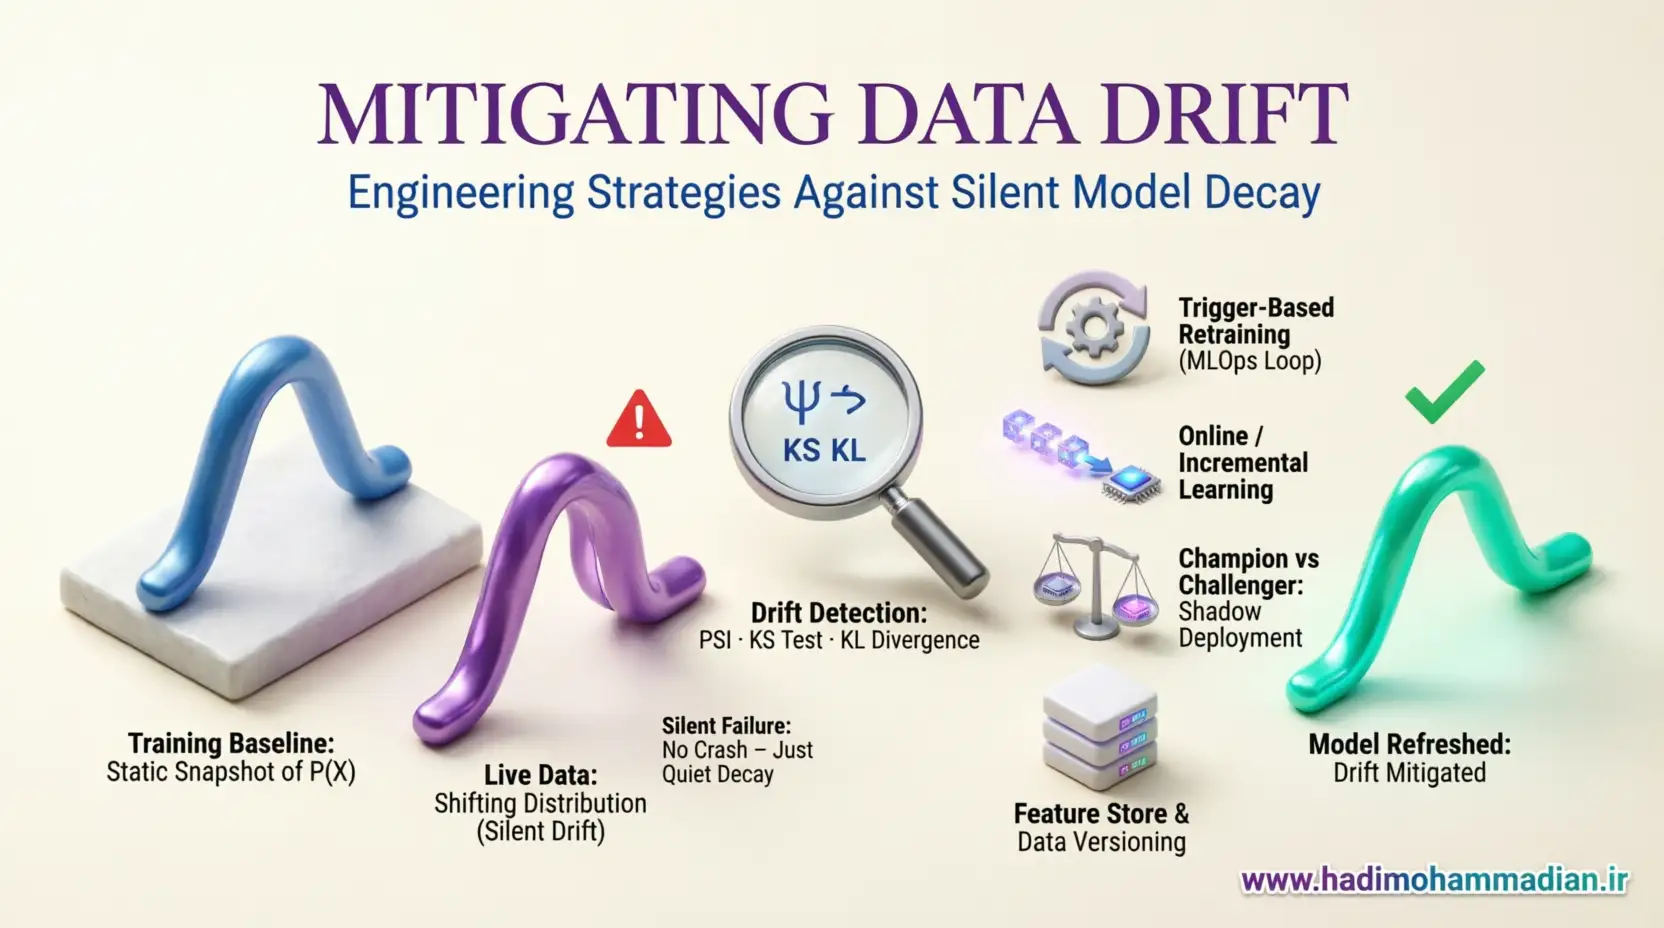
استراتژیهای مهندسی برای کاهش Data Drift: مقابله با فرسایش خاموش مدلها
بخش ۱: مقدمه – چرا مدلها در سکوت میمیرند؟
در محیطهای آزمایشگاهی (Jupyter Notebooks)، مدلهای یادگیری ماشین بر روی دادههای ایستا آموزش میبینند و تست میشوند. اما در دنیای واقعی، دادهها موجوداتی زنده و پویا هستند. رفتارهای کاربران تغییر میکند، روندهای اقتصادی جابجا میشوند و سنسورهای IoT فرسوده میشوند. کاهش Data Drift به یکی از مهمترین چالشهای مهندسی MLOps تبدیل شده است.
این تغییر در توزیع آماری دادههای ورودی نسبت به دادههای زمان آموزش، Data Drift نامیده میشود. خطرناکترین ویژگی Data Drift این است که معمولاً باعث شکست خاموش (Silent Failure) میشود. سیستم کرش نمیکند، هیچ خطای 500 بازگردانده نمیشود، اما دقت مدل به مرور زمان کاهش مییابد و تصمیمات غلط تجاری اتخاذ میشود (مثلاً وامهای بد تصویب میشوند یا محصولات نامرتبط پیشنهاد میشوند). کاهش Data Drift دقیقاً برای جلوگیری از این شکست خاموش طراحی شده است.
این شکست خاموش از این جهت خطرناک است که هیچ هشداری تولید نمیشود. سیستم به ظاهر درست کار میکند، اما خروجیهای آن به تدریج از واقعیت فاصله میگیرند. این مانند یک ساعت است که هر روز چند ثانیه عقب میماند — در ابتدا قابل توجه نیست، اما پس از چند ماه کاملاً گمراهکننده است. کاهش Data Drift به شما کمک میکند این انحراف را زود تشخیص دهید و اصلاح کنید.
🔑 نکته کلیدی: Data Drift یک باگ نیست؛ یک ویژگی از دنیای واقعی است که باید مدیریت شود. کاهش Data Drift نیازمند زیرساخت پیشگیرانه، پایش مداوم و استراتژیهای سازگاری هوشمند است.
بخش ۲: کالبدشکافی Data Drift برای کاهش Data Drift
قبل از ارائه راهکار برای کاهش Data Drift، باید نوع مشکل را بشناسیم. Data Drift معمولاً به دو شکل اصلی ظاهر میشود که هر کدام نیازمند استراتژی متفاوتی هستند.
۲.۱. تغییر متغیرهای کمکی (Covariate Shift) در کاهش Data Drift
توزیع متغیرهای ورودی P(X) تغییر میکند، اما رابطه بین ورودی و خروجی P(y|X) ثابت میماند.
مثال: مدل تشخیص چهرهای که با تصاویر جوانان آموزش دیده، اکنون باید سالمندان را تشخیص دهد. رابطه بین ویژگیهای صورت و هویت فرد ثابت است، اما توزیع ویژگیها تغییر کرده است. کاهش Data Drift در این حالت از طریق Importance Weighting امکانپذیر است.
۲.۲. تغییر احتمال پیشین (Prior Probability Shift) در کاهش Data Drift
توزیع برچسبهای خروجی P(y) تغییر میکند.
مثال: در دوران پاندمی، نسبت تراکنشهای اینترنتی (y=1) نسبت به حضوری به شدت افزایش یافت. این تغییر در نسبت کلاسها میتواند باعث بایاس در مدل شود. کاهش Data Drift در این حالت نیازمند Retraining است.
📊 جدول انواع Data Drift و استراتژیهای کاهش Data Drift
| نوع | تغییر | مثال | راهکار اصلی |
|---|---|---|---|
| 📊 Covariate Shift | P(X) | تشخیص چهره سالمندان | Importance Weighting |
| 📈 Prior Shift | P(y) | افزایش تراکنش اینترنتی | Retraining |
| 🔄 Concept Drift | P(y|X) | تغییر معنای رفتار | Online Learning |
💡 نکته: Concept Drift متفاوت است و به تغییر رابطه P(y|X) اشاره دارد، اما راهکارهای کاهش Data Drift همپوشانی زیادی با آن دارند.
برای مطالعه بیشتر درباره Covariate Shift، مقاله ویکیپدیا درباره Covariate Shift را ببینید.
بخش ۳: استراتژیهای پیشگیرانه برای کاهش Data Drift (Upstream Engineering)
بهترین راه کاهش Data Drift، کنترل ورودیها در سرچشمه است. این استراتژیها بر مهندسی داده و حاکمیت داده تمرکز دارند.
۳.۱. قراردادهای داده (Data Contracts) برای کاهش Data Drift
بسیاری از دریفتها ناشی از تغییرات ناخواسته در سیستمهای بالادستی (تولیدکنندگان داده) هستند. مثلاً تیم توسعه اپلیکیشن، واحد اندازهگیری duration را از «ثانیه» به «میلیثانیه» تغییر میدهد.
راهکار: پیادهسازی Data Contracts با استفاده از ابزارهایی مثل پروتوباف (Protobuf) یا JSON Schema. اگر داده ورودی با قرارداد (توزیع، نوع، بازه مقادیر) همخوانی نداشته باشد، پایپلاین باید در مرحله Ingestion متوقف شود و هشدار دهد، نه اینکه مدل پیشبینی غلط انجام دهد. این یکی از موثرترین روشهای کاهش Data Drift است.
۳.۲. Feature Store متمرکز برای کاهش Data Drift
یکی از دلایل رایج دریفت، Training-Serving Skew است؛ یعنی منطق محاسبه فیچرها در زمان آموزش (معمولاً Python/Pandas) با زمان سرویسدهی (مثلاً Java/Spark) متفاوت است.
راهکار: استفاده از Feature Store (مانند Feast یا Tecton). فیچر استور تضمین میکند که دقیقاً همان کدی که برای تولید فیچر آموزش استفاده شده، برای تولید فیچر بلادرنگ نیز استفاده میشود. این ثبات، دریفتهای تکنیکال را حذف میکند و به کاهش Data Drift کمک میکند.
📊 جدول استراتژیهای پیشگیرانه کاهش Data Drift
| استراتژی | هدف | ابزار |
|---|---|---|
| 📋 Data Contracts | کنترل ورودیها | Protobuf, JSON Schema |
| 🗂️ Feature Store | حذف Training-Serving Skew | Feast, Tecton |
| 📊 حاکمیت داده | استانداردسازی | Data Catalog |
مقاله داخلی ما با عنوان «Data Contracts چیست و چگونه پیادهسازی میشود؟» را مطالعه کنید.
بخش ۴: استراتژیهای تشخیص و پایش برای کاهش Data Drift (Monitoring & Detection)
شما نمیتوانید تغییرات رفتاری واقعی کاربران را «پیشگیری» کنید، اما میتوانید آنها را به سرعت «کشف» کنید. کاهش Data Drift نیازمند پایش مداوم است.
۴.۱. انتخاب متریکهای آماری مناسب برای کاهش Data Drift
نظارت بر میانگین و واریانس کافی نیست. باید از آزمونهای آماری برای مقایسه توزیع «پنجره مرجع» (دادههای آموزش) و «پنجره فعلی» (دادههای تولید) استفاده کنید:
| متریک | کاربرد | آستانه |
|---|---|---|
| 📊 PSI | استاندارد طلایی بانکداری | < 0.1 = خوب |
| 📈 KL Divergence | واگرایی دو توزیع | متغیر |
| 🎯 KS Test | تشخیص تفاوت توزیع | P-value < 0.05 |
| 🔄 Jensen-Shannon | نسخه متقارن KL | متغیر |
شاخص پایداری جمعیت (PSI): استاندارد طلایی در صنعت بانکداری برای کاهش Data Drift. اگر PSI < 0.1 باشد، تغییر ناچیز است. اگر PSI > 0.2 باشد، دریفت جدی است.
۴.۲. پنجرههای زمانی (Windowing Strategy) برای کاهش Data Drift
تشخیص دریفت به بازه زمانی بستگی دارد:
| نوع پنجره | کاربرد |
|---|---|
| ⚡ کوتاه مدت | کشف ناهنجاریهای ناگهانی |
| 📅 بلند مدت | کشف دریفت تدریجی |
سیستم مانیتورینگ کاهش Data Drift باید همزمان توزیع دادههای «یک ساعت اخیر» و «یک هفته اخیر» را با Baseline مقایسه کند.
برای مطالعه بیشتر درباره PSI، مستندات Evidently AI درباره PSI را ببینید.
مقاله داخلی ما با عنوان «مانیتورینگ مدلهای ML در تولید» را مطالعه کنید.
بخش ۵: استراتژیهای کاهش و سازگاری برای کاهش Data Drift (Mitigation & Adaptation)
وقتی سیستم مانیتورینگ آژیر قرمز (Drift Alert) را به صدا درآورد، سیستم مهندسی باید چه واکنشی نشان دهد؟ کاهش Data Drift در این مرحله حیاتی است.
۵.۱. آموزش مجدد خودکار (Automated Retraining – CT) برای کاهش Data Drift
این قلب تپنده MLOps برای کاهش Data Drift است.
روش: پایپلاین CI/CD/CT باید طوری طراحی شود که با دریافت تریگر از سیستم مانیتورینگ:
| مرحله | اقدام |
|---|---|
| 1️⃣ | دیتاست جدید آماده میشود |
| 2️⃣ | مدل بازآموزی میشود |
| 3️⃣ | مدل جدید ارزیابی میشود |
| 4️⃣ | اگر بهتر بود، جایگزین میشود |
💡 نکته: برای دادههای بدون لیبل، این روش نیازمند صبر کردن برای دریافت Ground Truth یا استفاده از تکنیکهای Human-in-the-loop است.
۵.۲. یادگیری آنلاین (Online Learning) برای کاهش Data Drift
برای سیستمهای بسیار پویا (مثل توصیهگرهای خبری یا قیمتگذاری بورس)، کاهش Data Drift از طریق Online Learning انجام میشود.
روش: مدل به صورت تدریجی (Incremental) با هر داده جدید آپدیت میشود.
ریسک: خطر «فیدبک لوپ» و مسمومیت مدل زیاد است. این روش نیازمند پایش بسیار دقیقتر است.
۵.۳. وزندهی اهمیت (Importance Weighting) برای کاهش Data Drift
اگر امکان بازآموزی کامل وجود ندارد، میتوانیم تاثیر دریفت متغیرهای کمکی (Covariate Shift) را کاهش دهیم.
روش: به نمونههای آموزشی که شبیه دادههای جدید (تولید) هستند، وزن بیشتری میدهیم. با استفاده از نسبت تراکم (Density Ratio Estimation) میتوان مدل را بدون نیاز به لیبلهای جدید سازگار کرد. این روش برای کاهش Data Drift در Covariate Shift بسیار موثر است.
۵.۴. حالت سایه و قناری (Shadow & Canary Deployment) برای کاهش Data Drift
هرگز مدل جدید را ناگهانی جایگزین نکنید:
| حالت | توضیح |
|---|---|
| 🌑 Shadow Mode | خروجی به کاربر داده نمیشود |
| 🐤 Canary | فقط ۱۰٪ ترافیک |
📊 جدول استراتژیهای سازگاری برای کاهش Data Drift
| استراتژی | سرعت | ریسک | مناسب برای |
|---|---|---|---|
| 🔄 Retraining | کند | کم | دریفت تدریجی |
| ⚡ Online Learning | سریع | بالا | سیستمهای پویا |
| ⚖️ Importance Weighting | متوسط | کم | Covariate Shift |
| 🌑 Shadow/Canary | متوسط | کم | استقرار امن |
برای مطالعه بیشتر درباره Continuous Training، مستندات Kubeflow را ببینید.
بخش ۶: نتیجهگیری – کاهش Data Drift به عنوان بخشی از چرخه حیات
مهندسی کاهش Data Drift به معنای تلاش برای ثابت نگه داشتن جهان نیست؛ بلکه به معنای ساختن سیستمهایی است که انعطافپذیر (Resilient) باشند.
📌 اصول کلیدی موفقیت در کاهش Data Drift
| اصل | توضیح |
|---|---|
| 🛡️ پیشگیری | Data Contracts + Feature Store |
| 🔍 تشخیص | PSI + KL Divergence |
| 🔄 سازگاری | Continuous Training |
| 🚀 استقرار امن | Shadow + Canary |
💡 پیام نهایی: در نهایت، دریفت یک باگ نیست؛ یک ویژگی از دنیای واقعی است که باید مدیریت شود. سازمانهای موفق آنهایی هستند که این واقعیت را پذیرفته و زیرساخت لازم برای کاهش Data Drift را ساختهاند. با پیادهسازی استراتژیهای پیشگیرانه، پایش مداوم و سازگاری هوشمند، میتوانید مدلهای ML خود را در برابر فرسایش خاموش مقاوم کنید.