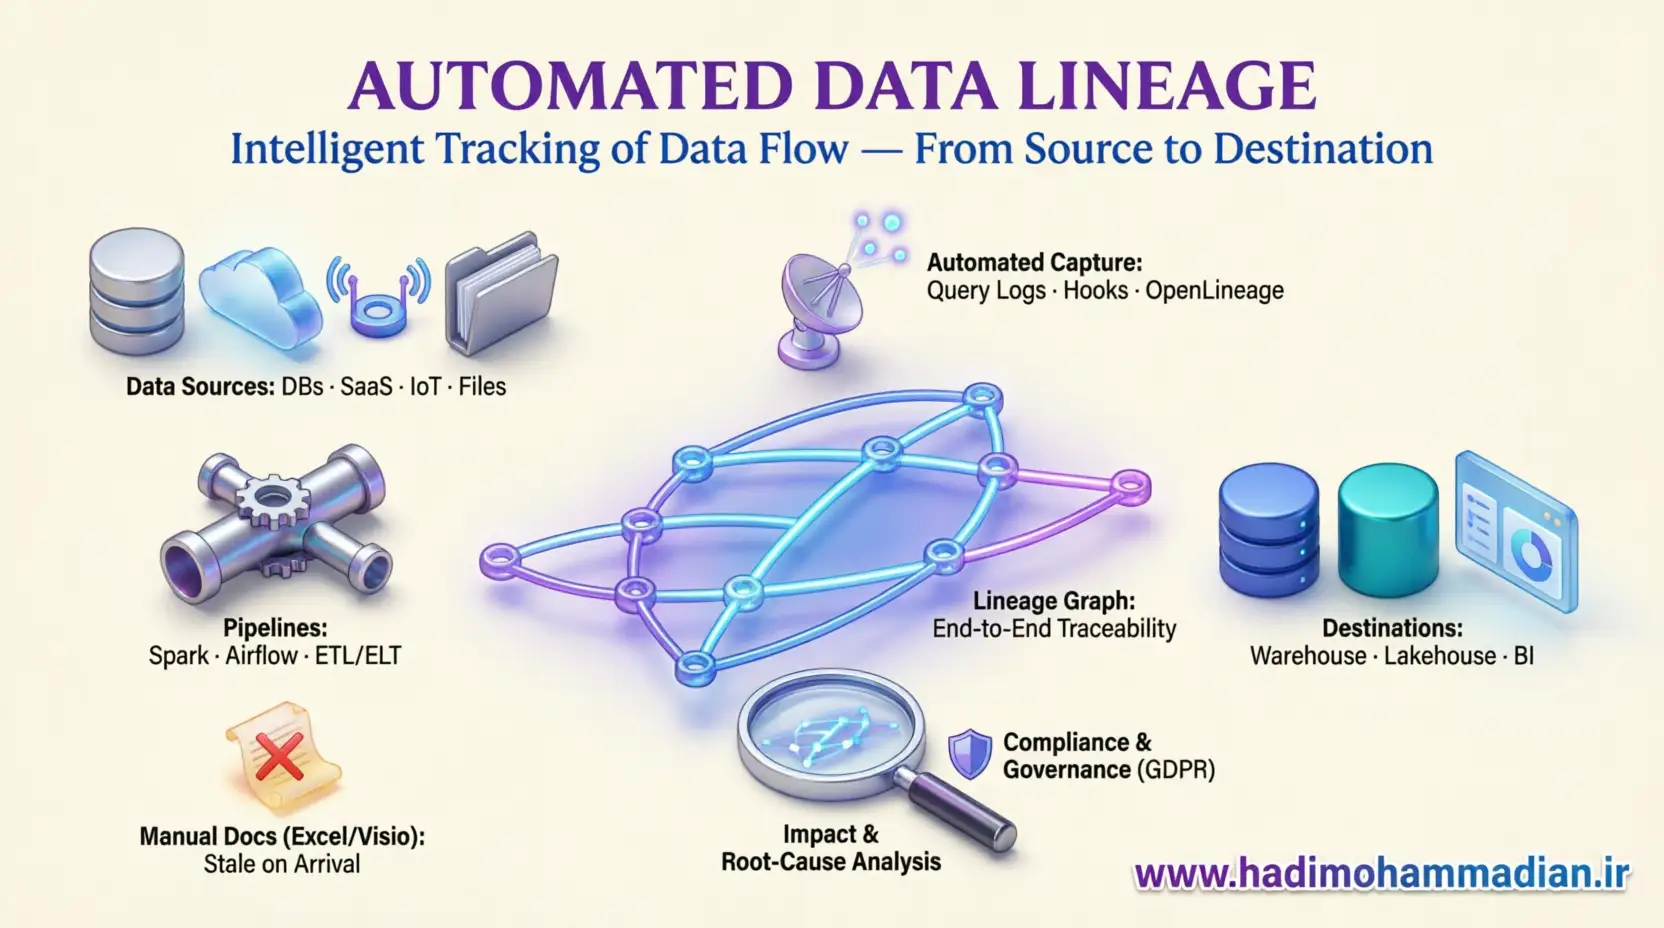
معماری Data Lineage اتوماتیک: ردیابی هوشمند گردش داده از مبدا تا مقصد
🔴 بخش ۱: مقدمه – چرا نقشههای دستی در Data Lineage اتوماتیک شکست میخورند؟
در گذشته، سازمانها سعی میکردند جریان دادههای خود را در فایلهای اکسل یا ابزارهای ویزیو (Visio) مستند کنند. این روش در عصر بیگ دیتا کاملاً منسوخ شده است. وقتی شما هزاران جدول در انبار داده، صدها میکروسرویس و دهها پایپلاین Spark/Airflow دارید که روزانه تغییر میکنند، هر مستند دستی در لحظه انتشار «قدیمی» شده است. Data Lineage اتوماتیک دقیقاً برای حل این چالش ظهور کرده است.
این تغییر پارادایم نتیجه رشد تصاعدی پیچیدگی سیستمهای داده است. در گذشته، یک سازمان ممکن بود چند ده جدول و چند پایپلاین ساده داشته باشد که مستندسازی دستی آنها چند روز طول میکشید. اما امروزه، با حضور هزاران جدول، صدها میکروسرویس و دهها پایپلاین پیچیده که روزانه تغییر میکنند، مستندسازی دستی نه تنها غیرعملی بلکه غیرممکن است.
Data Lineage اتوماتیک، فرآیند استخراج، پردازش و بصریسازی جریان دادهها بدون دخالت انسان است. این سیستم به سوالات حیاتی زیر پاسخ میدهد:
| سوال | کاربرد |
|---|---|
| 🔍 این عدد از کجا آمده؟ | ردیابی منبع داده |
| ⚠️ کدام گزارشها خراب میشوند؟ | Impact Analysis |
| 🐛 داده در کجا خراب شده؟ | Root Cause Analysis |
🔑 نکته کلیدی: در دنیای دادههای مدرن، ندانستن مسیر حرکت دادهها مانند پرواز در تاریکی است. Data Lineage اتوماتیک چراغی است که مسیر را روشن میکند.
🟠 بخش ۲: معماری سطح بالا در Data Lineage اتوماتیک (High-Level Architecture)
یک سیستم Data Lineage اتوماتیک مدرن از چهار لایه اصلی تشکیل شده است که هر کدام نقش حیاتی در ایجاد یک تصویر کامل از جریان دادهها ایفا میکنند.
📊 ۲.۱. لایه استخراج (Instrumentation & Extraction) در Data Lineage اتوماتیک
این لایه وظیفه دارد متادیتا را از سیستمهای پردازشی «شکار» کند. سه روش اصلی برای این کار وجود دارد:
| روش | نوع | توضیح |
|---|---|---|
| 📝 SQL Parsing | استاتیک | خواندن کدهای SQL و تبدیل به درخت تجزیه |
| ⚡ Runtime Instrumentation | پویا | استفاده از Listenerها در زمان اجرا |
| 📊 Log Analysis | پسرویدادی | تحلیل Query Logهای دیتابیس |
SQL Parsing (استاتیک): خواندن کدهای SQL یا Stored Procedureها و تبدیل آنها به درخت تجزیه انتزاعی (AST) برای فهمیدن اینکه Table A خوانده شده و در Table B نوشته شده است.
Runtime Instrumentation (پویا): استفاده از Listenerها و Agentها در زمان اجرا. مثلاً یک SparkListener که هنگام اجرای جاب، میبیند کدام فایل Parquet خوانده شده و کجا نوشته میشود.
Log Analysis (پسرویدادی): تحلیل Query Logهای دیتابیس (مثلاً Query History در Snowflake) برای استخراج روابط.
🔄 ۲.۲. لایه استانداردسازی (Standardization) در Data Lineage اتوماتیک
دادههای استخراج شده فرمتهای مختلفی دارند. یک استاندارد جهانی (مانند OpenLineage) برای یکسانسازی این متادیتا استفاده میشود تا «زبان مشترکی» بین Airflow، Spark، Flink و Snowflake ایجاد شود. این استانداردسازی برای ایجاد یک تصویر یکپارچه از Data Lineage اتوماتیک ضروری است.
🕸️ ۲.۳. لایه ذخیرهسازی گراف (Graph Storage) در Data Lineage اتوماتیک
Lineage ذاتاً یک گراف جهتدار (DAG) است. بنابراین دیتابیسهای رابطهای برای ذخیره آن مناسب نیستند. از دیتابیسهای گراف (مانند Neo4j, JanusGraph) یا مخازن متادیتای اختصاصی برای ذخیره Nodes (دیتاستها و جابها) و Edges (ورودیها و خروجیها) استفاده میشود.
🖥️ ۲.۴. لایه مصرف (Consumption) در Data Lineage اتوماتیک
APIها و واسطهای کاربری که گراف را نمایش میدهند و امکان جستجوی معکوس (Upstream/Downstream traversal) را فراهم میکنند.
📊 جدول لایههای معماری Data Lineage اتوماتیک
| لایه | نقش | ابزارها |
|---|---|---|
| 📥 استخراج | شکار متادیتا | SQL Parser, Spark Listener |
| 🔄 استانداردسازی | یکسانسازی فرمت | OpenLineage |
| 🕸️ ذخیرهسازی | گراف Lineage | Neo4j, Marquez |
| 🖥️ مصرف | نمایش و جستجو | DataHub UI |
برای مطالعه بیشتر درباره OpenLineage، مستندات رسمی OpenLineage را ببینید.
🟡 بخش ۳: استاندارد OpenLineage – زبان مشترک Data Lineage اتوماتیک
تا قبل از ظهور OpenLineage، هر ابزاری فرمت خاص خود را داشت. Data Lineage اتوماتیک با OpenLineage یکپارچه شد. OpenLineage یک پروژه متنباز (تحت بنیاد لینوکس) است که یک فرمت JSON استاندارد برای رویدادهای Lineage تعریف میکند.
📊 موجودیتهای اصلی OpenLineage در Data Lineage اتوماتیک
| موجودیت | توضیح | نمونه |
|---|---|---|
| 📦 Job | فرآیندی که اجرا میشود | تسک در Airflow |
| ⚡ Run | اجرای خاص در زمان مشخص | اجرای روزانه |
| 📁 Datasets | ورودیها و خروجیها | جداول و فایلها |
📝 مثال JSON ساده شده در Data Lineage اتوماتیک
{
  "eventType": "COMPLETE",
  "eventTime": "2023-10-27T10:00:00.000Z",
  "run": { "runId": "d46e..." },
  "job": { "namespace": "my-airflow", "name": "daily_etl.task_a" },
  "inputs": [{ "namespace": "postgres", "name": "public.raw_orders" }],
  "outputs": [{ "namespace": "s3", "name": "s3://bucket/clean_orders" }]
}
💡 نکته: استاندارد OpenLineage مانند زبان انگلیسی برای سیستمهای Data Lineage اتوماتیک است — همه ابزارها با این زبان مشترک صحبت میکنند.
مقاله داخلی ما با عنوان «OpenLineage چیست؟» را مطالعه کنید.
🟢 بخش ۴: تکنیکهای عمیق استخراج در Data Lineage اتوماتیک
📝 ۴.۱. تجزیه SQL (SQL Parsing) در Data Lineage اتوماتیک
برای دیتابیسهای سنتی و کوئریهای dbt، پارس کردن SQL حیاتی است. ابزارهایی (مانند کتابخانههای داخلی DataHub یا Python sqlglot) کوئری زیر را تحلیل میکنند:
INSERT INTO regional_sales
SELECT r.region, SUM(o.amount)
FROM orders o
JOIN regions r ON o.region_id = r.id
GROUP BY r.region;
خروجی Lineage در Data Lineage اتوماتیک:
| نوع | مقدار |
|---|---|
| 📥 Inputs | orders, regions |
| 📤 Output | regional_sales |
| 📊 Column Lineage | regional_sales.amount ← orders.amount (Aggregation) |
⚡ ۴.۲. شنوندگان Spark (Spark Listeners) در Data Lineage اتوماتیک
در Apache Spark، پارس کردن کد کافی نیست (چون کدها Dynamic هستند). ما از QueryExecutionListener استفاده میکنیم.
| مرحله | اقدام |
|---|---|
| 1️⃣ | DataFrame ذخیره میشود |
| 2️⃣ | Spark طرح منطقی تولید میکند |
| 3️⃣ | Agent طرح را میخواند |
| 4️⃣ | منابع داده شناسایی میشوند |
| 5️⃣ | رویداد OpenLineage ارسال میشود |
برای مطالعه بیشتر درباره Spark Listeners، مستندات Apache Spark را ببینید.
🔵 بخش ۵: چالش بزرگ – تبارشناسی در سطح ستون (Column-Level Lineage) در Data Lineage اتوماتیک
دانستن اینکه «جدول A به جدول B میریزد» (Table-Level) خوب است، اما کافی نیست. سوال واقعی در Data Lineage اتوماتیک معمولاً این است: «ستون credit_score در جدول نهایی از کجا آمده است؟»
چرا Column-Level Lineage دشوارتر است؟
| چالش | توضیح |
|---|---|
| 🔧 توابع پیچیده | تحلیل CASE WHEN، CONCAT، UDFs |
| 📊 SELECT * | نیاز به Resolve اسکیما در زمان اجرا |
| 💾 حجم گراف | افزایش شدید تعداد گرهها |
ابزارهای مدرن مانند dbt (به صورت Native) و پلتفرمهایی مثل Atlan یا DataHub تمرکز زیادی روی حل این چالش با ترکیب SQL Parsing و Metadata Fetching دارند.
مقاله داخلی ما با عنوان «Column-Level Lineage در DataHub» را مطالعه کنید.
🟣 بخش ۶: پشته تکنولوژی پیشنهادی برای Data Lineage اتوماتیک (Recommended Stack)
📊 جدول پشته تکنولوژی Data Lineage اتوماتیک
| لایه | ابزار | نقش |
|---|---|---|
| 📥 جمعآوری | Airflow OpenLineage Provider | استخراج از DAGها |
| ⚡ جمعآوری | Spark OpenLineage Integration | استخراج از جابها |
| 📝 جمعآوری | dbt | Lineage مدلهای SQL |
| 🕸️ Backend | Marquez | مخزن OpenLineage |
| 🕸️ Backend | DataHub | پلتفرم کاتالوگ داده |
| 🖥️ UI | Marquez/DataHub UI | بصریسازی |
📊 جدول مقایسه ابزارهای Data Lineage اتوماتیک
| ابزار | مزایا | معایب |
|---|---|---|
| 🕸️ Marquez | Reference Implementation | امکانات محدودتر |
| 🏛️ Apache Atlas | کامل و بالغ | سنگین و قدیمی |
| 📊 DataHub | مدرن و قوی | پیچیدگی راهاندازی |
برای مطالعه مقایسه کامل، مستندات Marquez را ببینید.
🟤 بخش ۷: کاربردهای عملیاتی Data Lineage اتوماتیک (Use Cases)
⚠️ ۷.۱. تحلیل اثر (Impact Analysis) در Data Lineage اتوماتیک
قبل از اینکه مهندس داده ستونی را حذف کند، در سیستم Data Lineage اتوماتیک چک میکند: «چه کسانی از این ستون استفاده میکنند؟»
نتیجه: سیستم نشان میدهد که ۳ داشبورد Tableau و یک مدل ML به این ستون وابستهاند. نتیجه: جلوگیری از شکست سیستم.
🐛 ۷.۲. دیباگ داده (Data Debugging) در Data Lineage اتوماتیک
مدیر مالی گزارش میدهد که سود ماهانه ۱۰٪ اشتباه است. مهندس داده در گراف Data Lineage اتوماتیک روی KPI سود کلیک میکند و مسیر را به عقب (Upstream) میرود تا ببیند کدام جاب ETL تغییر کرده یا کدام سورس داده با تاخیر آپدیت شده است.
🔒 ۷.۳. انطباق با قوانین (GDPR/Compliance) در Data Lineage اتوماتیک
قانون میگوید «دادههای شخصی کاربران (PII) نباید در محیطهای توسعه (Dev) کپی شوند». با استفاده از Data Lineage اتوماتیک و تگگذاری خودکار، میتوانید اثبات کنید که دادههای حساس در کدام جداول جریان یافتهاند.
📊 جدول کاربردهای Data Lineage اتوماتیک
| کاربرد | سوال | ابزار |
|---|---|---|
| ⚠️ Impact Analysis | چه کسانی وابستهاند؟ | Lineage Graph |
| 🐛 Debugging | کجا خراب شده؟ | Upstream Traversal |
| 🔒 Compliance | داده کجا رفته؟ | Tagging + Lineage |
برای مطالعه بیشتر درباره GDPR، مقررات عمومی حفاظت از داده اتحادیه اروپا را ببینید.
✅ بخش ۸: نتیجهگیری – چکلیست نهایی Data Lineage اتوماتیک
معماری Data Lineage اتوماتیک دیگر یک ابزار لوکس نیست، بلکه زیرساخت حیاتی برای مقیاسپذیری تیمهای داده است. بدون آن، با افزایش حجم دادهها و پیچیدگی پایپلاینها، تیم داده در تاریکی پرواز میکند.
📌 نکات کلیدی موفقیت در Data Lineage اتوماتیک
| اصل | توضیح |
|---|---|
| 📝 استانداردسازی | استفاده از OpenLineage |
| ⚡ اتوماسیون کامل | بدون دخالت انسان |
| 🕸️ گراف ذخیرهسازی | Neo4j/Marquez |
| 📊 Column-Level | برای دقت بیشتر |
💡 پیام نهایی: با پذیرش استاندارد OpenLineage و ادغام آن در لایه Orchestration (مثل Airflow)، سازمانها میتوانند به «رویتپذیری» (Observability) کامل بر جریان خون اطلاعاتی خود دست یابند. Data Lineage اتوماتیک نه تنها شفافیت را افزایش میدهد، بلکه اعتماد به دادهها را در سراسر سازمان تقویت میکند.