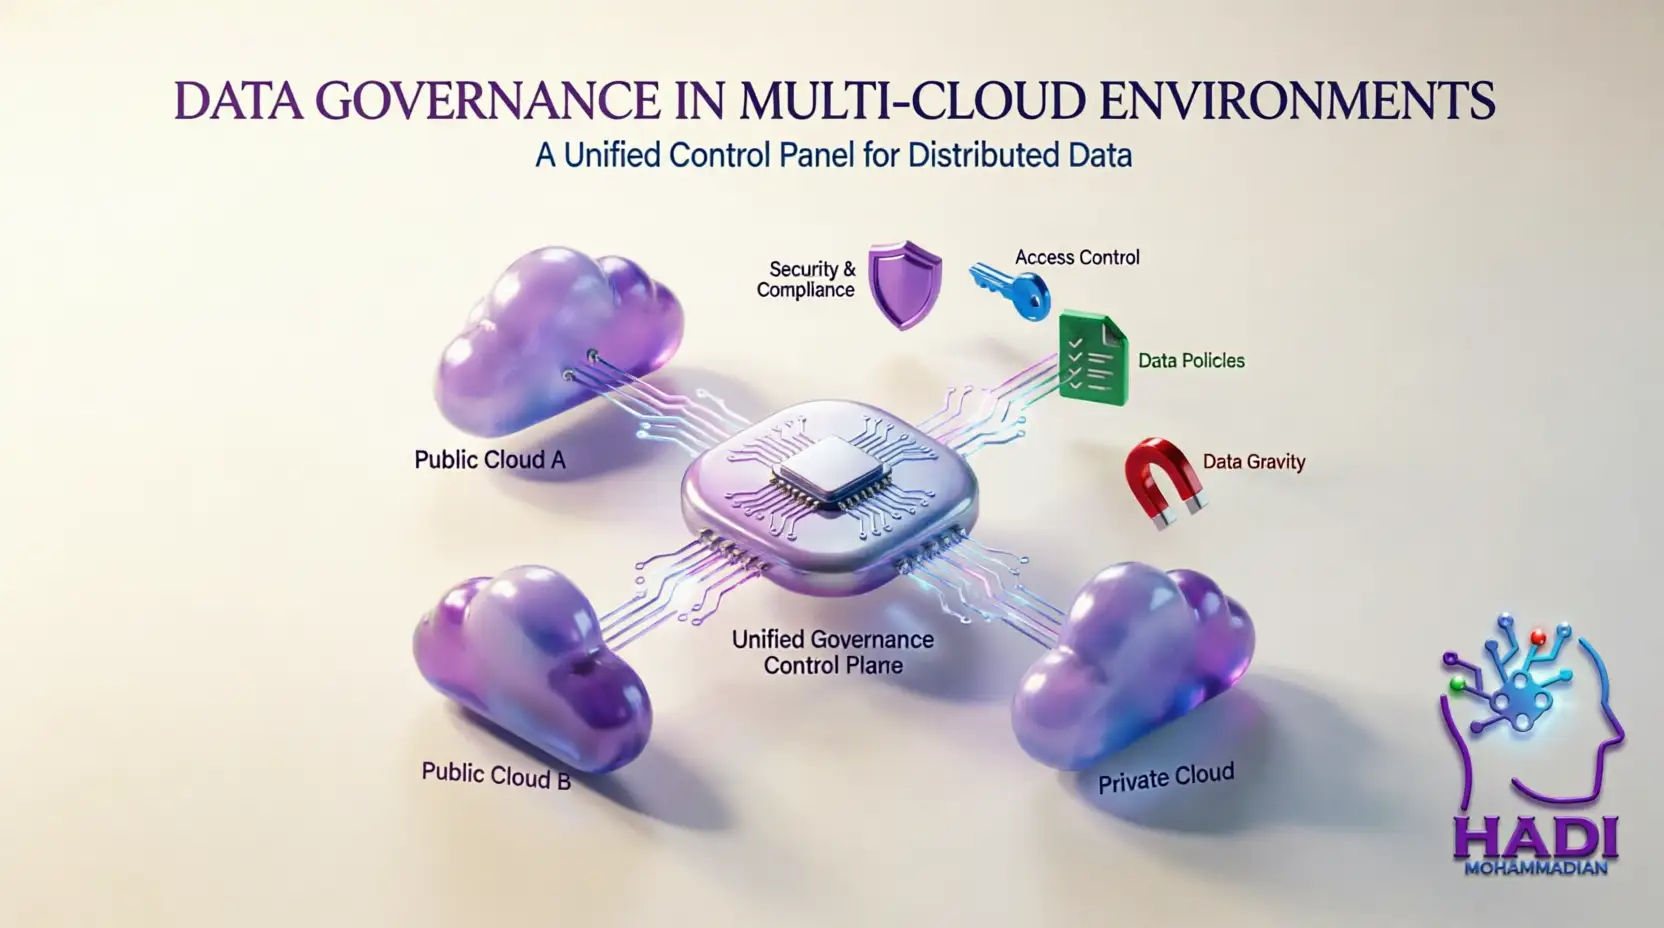
استراتژیهای حاکمیت داده در محیط چند-ابری (Multi-Cloud)
در دنیای امروز، حاکمیت داده در محیط چند-ابری به یک ضرورت استراتژیک برای سازمانهای بزرگ تبدیل شده است. دوران «تکابری» به پایان رسیده و سازمانها به دلایل مختلف از جمله کاهش وابستگی به فروشنده، ادغام و تملک، بهرهبرداری از بهترین سرویسها و انطباق مقرراتی، در محیطهای چندابری زیست میکنند. اما چالش اصلی، «جاذبه داده» (Data Gravity) است که جابهجایی دادهها را پرهزینه و دشوار میکند. حاکمیت داده در محیط چند-ابری دقیقاً به همین چالش پاسخ میدهد: چگونه میتوانیم یک «کنترل پنل واحد» داشته باشیم وقتی دادهها در جزایر جداگانه فیزیکی و منطقی پخش شدهاند؟
📊 چرا سازمانها به سمت Multi-Cloud میروند؟
| دلیل | توضیح | مثال |
|---|---|---|
| کاهش Vendor Lock-in | عدم وابستگی به یک فروشنده خاص | استفاده از AWS + Azure همزمان |
| ادغام و تملک (M&A) | شرکتهای ادغامشده زیرساختهای متفاوت دارند | شرکت A در AWS، شرکت B در Azure |
| Best-of-Breed | انتخاب بهترین سرویس از هر ابر | AI از Google، زیرساخت از AWS |
| انطباق مقرراتی | قوانین محلی نیاز به استقرار داده در مناطق خاص دارد | Data Residency در اروپا |
| تابآوری (Resilience) | کاهش ریسک قطعی سرویس | Failover بین ابرها |
⚠️ مشکل اصلی: جاذبه داده (Data Gravity)
دادهها مانند اپلیکیشنها نیستند. اپلیکیشنها سبک و قابل حمل هستند، اما دادهها دارای «جاذبه» هستند. برای پیادهسازی موفق حاکمیت داده در محیط چند-ابری، ابتدا باید این واقعیت را بپذیریم که جابهجایی فیزیکی دادهها تقریباً همیشه شکست میخورد. ابزارهای بومی هر ابر مانند AWS Lake Formation یا Azure Purview نیز تنها دید محدودی به اکوسیستم خود دارند و نمیتوانند یکپارچگی لازم را فراهم کنند.
🎯 استراتژی حاکمیت داده در محیط چند-ابری یعنی: ایجاد یک لایه انتزاعی که بر فراز تمام ابرها قرار میگیرد و کنترل را متمرکز میکند، بدون آنکه دادهها را جابهجا کند.
🟠 بخش ۲: پارادوکس حاکمیت داده در محیط چند-ابری – تمرکز در برابر فدرالیسم
اولین تصمیم استراتژیک در حاکمیت داده در محیط چند-ابری، انتخاب مدل عملیاتی است. سه رویکرد وجود دارد:
الف) رویکرد متمرکز فیزیکی (The Data Lakehouse Monolith) 🏢
| جنبه | توضیح |
|---|---|
| روش | کپی کردن تمام دادهها از همه ابرها به یک ابر مرکزی |
| حکم | ❌ تقریباً همیشه شکست میخورد |
| دلیل | هزینههای انتقال داده (Egress) و تاخیر (Latency) غیرعملی است |
| مشکل اضافه | ایجاد نسخههای تکراری و ناهمگام |
ب) رویکرد سیلویی (Siloed Governance) 🏝️
| جنبه | توضیح |
|---|---|
| روش | استفاده از ابزارهای بومی هر ابر به صورت جداگانه |
| نمونه | تیم A با AWS Glue، تیم B با Azure Data Catalog |
| حکم | ❌ منجر به ناهماهنگی و ضعف امنیتی |
| مشکلات | KPIهای متفاوت، عدم دید جامع، خطای انسانی |
ج) رویکرد فدرال / توزیع شده (The Federated Model) ⭐ توصیه شده
| جنبه | توضیح |
|---|---|
| اصل | دادهها در جای خود باقی میمانند (Compute moves to Data) |
| تمرکز | «فراداده» (Metadata) و «سیاستها» (Policies) متمرکز هستند |
| پایه | جداسازی Control Plane از Data Plane |
| مزیت | انعطافپذیری + کنترل یکپارچه |
🔑 نکته کلیدی: در مدل فدرال، حاکمیت داده در محیط چند-ابری به معنای جابهجا نکردن دادهها، بلکه متمرکز کردن کنترل است، نه فیزیک.
🟡 بخش ۳: معماری مرجع حاکمیت داده در محیط چند-ابری – لایه انتزاعی
برای موفقیت در حاکمیت داده در محیط چند-ابری، باید یک لایه منطقی بالای ابرها ایجاد کنید. این لایه شامل اجزای زیر است:
۱. Metastore جهانی (Universal Metastore) 🗂️
| جنبه | توضیح |
|---|---|
| عملکرد | یک کاتالوگ که به S3 در AWS، Blob در Azure و BigQuery در GCP متصل است |
| خروجی | نمایش همه دادهها در یک گراف دانش (Knowledge Graph) |
| ابزارها | Alation, Collibra, Atlan, DataHub |
۲. موتور سیاستگذاری چندگانه (Cross-Platform Policy Engine) ⚙️
یک قانون بیزینسی واحد («دادههای PII ماسک شوند») به صورت خودکار ترجمه میشود به:
| پلتفرم | مکانیزم اعمال |
|---|---|
| AWS | IAM Policy |
| Azure SQL | Dynamic Masking Rule |
| Google BigQuery | Row-Level Security |
برای آشنایی با استانداردهای سیاستگذاری، Open Policy Agent را ببینید.
۳. لایه مجازیسازی (Virtualization Layer) 🔄
| ابزار | قابلیت |
|---|---|
| Starburst (Presto/Trino) | Join دادههای دو ابر با یک کوئری SQL واحد |
| Denodo | مجازیسازی داده سازمانی |
✨ مزیت کلیدی: بدون جابجایی دادهها، تحلیل یکپارچه انجام میشود. برای مطالعه بیشتر درباره معماری Data Fabric، تعریف گارتنر از Data Fabric را ببینید.
🟢 بخش ۴: استراتژیهای کلیدی برای یکپارچگی حاکمیت داده در محیط چند-ابری
استراتژی ۱: بافت داده (Data Fabric) به عنوان ستون فقرات 🕸️
دیتا فابریک یک مفهوم معماری است، نه یک محصول واحد. در حاکمیت داده در محیط چند-ابری، فابریک نقش سیستم عصبی را بازی میکند.
| جنبه | توضیح |
|---|---|
| عملکرد | استفاده از هوش مصنوعی برای کشف خودکار دادهها در تمام ابرها |
| مثال | ستون حساس جدید در AWS ایجاد میشود → فابریک آن را شناسایی میکند → بر اساس الگوهای یاد گرفته شده از Azure، همان برچسب امنیتی را اعمال میکند |
| مزیت | حذف خطای انسانی در هماهنگسازی سیاستها بین ابرها |
مقاله داخلی ما با عنوان «Data Fabric چیست و چگونه پیادهسازی میشود؟» را مطالعه کنید.
استراتژی ۲: مجازیسازی داده برای کاهش کپیبرداری 🔄
| جنبه | روش سنتی (ETL) | روش مدرن (Virtualization) |
|---|---|---|
| روش | پایپلاینهای پیچیده برای کپی همه چیز به یکجا | کوئری شکسته شده، هر بخش به منبع خود ارسال میشود |
| ابزار | Informatica, Talend | Trino, Starburst, Denodo |
| نتیجه | کپیهای متعدد و ناهمگام | ترکیب نتایج در حافظه (Memory) |
| تاثیر بر حاکمیت | ریسک امنیتی بالا | ✅ کپی کمتر = ریسک کمتر + همگامی بیشتر |
استراتژی ۳: سیاست به عنوان کد (Policy-as-Code) توزیع شده 📜
| جنبه | توضیح |
|---|---|
| ابزار | Open Policy Agent (OPA) |
| زبان | Rego |
| محل ذخیره | مخزن Git مرکزی |
| مکانیزم | ایجنتهای OPA در کلاسترهای Kubernetes در AWS، Azure و On-prem مستقر هستند |
| عملکرد | دورهای سیاستهای جدید را از Git میگیرند (Pull) و اعمال میکنند |
| نتیجه | تعریف «امنیت» در تمام ابرها دقیقاً یکسان است |
🔵 بخش ۵: مدیریت هویت و دسترسی در حاکمیت داده در محیط چند-ابری (Cross-Cloud IAM)
سختترین بخش فنی در حاکمیت داده در محیط چند-ابری، مدیریت هویت است. کاربر alice@company.com باید در تمام ابرها یک هویت واحد داشته باشد.
فدراسیون هویت (Identity Federation) 🔐
| جنبه | توضیح |
|---|---|
| روش | استفاده از یک IdP مرکزی (Okta یا Azure AD) |
| اعتماد | همه ابرها به آن اعتماد دارند |
| پروتکلها | SAML 2.0, OAuth 2.0, OIDC |
چالش نگاشت (Mapping Challenge) 🗺️
| ابر | مکانیزم دسترسی |
|---|---|
| AWS | IAM Roles |
| Azure | Security Groups |
| GCP | IAM Bindings |
راهکار: Attribute-Based Access Control (ABAC) ⭐
| جنبه | توضیح |
|---|---|
| روش سنتی (RBAC) | «گروه مدیران به باکت X دسترسی دارد» |
| روش ABAC | «هر کسی که ویژگی Department=Finance را در توکن ادعای خود دارد، به منابعی که تگ Owner=Finance دارند دسترسی دارد» |
| مزیت | منطق مستقل از پلتفرم ابری است |
برای مطالعه بیشتر درباره فدراسیون هویت، مستندات Microsoft درباره Identity Federation را ببینید.
🟣 بخش ۶: حاکمیت حاکمیت (Sovereignty Governance) – مدیریت مرزهای جغرافیایی در حاکمیت داده در محیط چند-ابری
در حاکمیت داده در محیط چند-ابری جهانی، قوانین محلی (Data Residency) کابوس هستند.
چالشهای قانونی
| قانون | الزام |
|---|---|
| GDPR | دادههای شهروندان آلمان نباید از اتحادیه اروپا خارج شود |
| CCPA | حقوق مصرفکنندگان کالیفرنیا |
| Data Localization | برخی کشورها دادهها را باید داخل مرز نگه دارند |
استراتژی Geofencing 🌍
| جنبه | توضیح |
|---|---|
| روش | متادیتای هر منبع داده شامل تگ Region است |
| عملکرد | موتور حاکمیت هرگونه درخواست دسترسی یا پایپلاین انتقال داده را بررسی میکند |
| مثال | انتقال از EU-West (فرانکفورت) به US-East (ویرجینیا) مسدود میشود |
| استثنا | مگر اینکه دادهها ناشناسسازی (Anonymized) شده باشند |
برای آشنایی با GDPR، مقررات عمومی حفاظت از داده اتحادیه اروپا را ببینید.
🟤 بخش ۷: سناریوی عملیاتی – پیادهسازی حاکمیت داده در محیط چند-ابری در یک شرکت لجستیک جهانی
📋 مشخصات شرکت: “LogiWorld”
| محیط | کاربرد |
|---|---|
| AWS | پلتفرم IoT برای ردیابی کامیونها |
| Azure | سیستم مالی و ERP |
| On-Prem | سیستمهای قدیمی انبارداری |
| GCP | تحلیل دادههای هوش مصنوعی برای بهینهسازی مسیر |
هدف: ایجاد دسترسی امن برای دیتاساینتیستها جهت پیشبینی تاخیر تحویل (نیاز به دادههای هر ۳ محیط)
🎯 گام ۱: استقرار کاتالوگ یکپارچه (Unified Cataloging)
| اقدام | توضیح |
|---|---|
| ابزار | Alation یا Collibra |
| اتصال | ایجنتها (Crawlers) به VPCهای AWS، VNetهای Azure و دیتاسنتر متصل میشوند |
| نتیجه | نقشهای کامل از تمام دادهها بدون جابجایی دادهها |
🎯 گام ۲: طبقهبندی خودکار (Auto-Classification)
| محیط | یافتهها |
|---|---|
| Azure | ستون CreditCard پیدا میشود |
| AWS | مختصات GPS خانه رانندگان در پیامهای JSON به عنوان PII شناسایی میشود |
| نتیجه | برچسب Confidential به صورت سراسری اعمال میشود |
🎯 گام ۳: لایه دسترسی مجازی (Virtual Access Layer)
| اقدام | توضیح |
|---|---|
| ابزار | Starburst (Trino) |
| روش | به جای کپی کردن دادههای IoT به Azure |
| خروجی | Data Product مجازی به نام «تحلیل تاخیر» |
🎯 گام ۴: اعمال سیاست امنیتی (Policy Enforcement)
| جنبه | توضیح |
|---|---|
| ابزار | Privacera یا Apache Ranger |
| سیاست | «دسترسی به مختصات GPS دقیق فقط برای مدیران عملیات مجاز است. دیتاساینتیستها باید دادهها را با دقت ۱۰ کیلومتر (Blurring) ببینند.» |
| اجرا | در لحظه کوئری (Runtime) توسط موتور مجازیسازی |
| نتیجه | دیتاساینتیست نتایج را به صورت تقریبی دریافت میکند، فارغ از اینکه داده در AWS است یا Azure |
⚫ بخش ۸: FinOps و حاکمیت هزینه دادهها در حاکمیت داده در محیط چند-ابری
در حاکمیت داده در محیط چند-ابری، حاکمیت فقط امنیت نیست، هزینه است.
مشکلات هزینهای رایج
| مشکل | توضیح |
|---|---|
| کوئریهای بد | در BigQuery میتواند بودجه IT را نابود کند |
| Data Egress | انتقال بیرویه داده بین ابرها هزینه بالایی دارد |
استراتژیهای حاکمیت FinOps
| استراتژی | توضیح |
|---|---|
| تگگذاری هزینه (Cost Tagging) | اجبار تگهای CostCenter روی تمام باکتها و دیتابیسها |
| سهمیهبندی (Quotas) | سقف بودجه برای هر پروژه در سطح کاتالوگ داده |
| تشخیص دادههای سرد | شناسایی دادههای ۶ ماهه دستنخورده و پیشنهاد انتقال به Glacier |
| Lifecycle Management | مدیریت خودکار چرخه حیات دادهها |
برای مطالعه بهترین شیوههای FinOps، بنیاد FinOps را ببینید.
⚪ بخش ۹: چالشهای فنی و فرهنگی در حاکمیت داده در محیط چند-ابری
| چالش | راهکار |
|---|---|
| تاخیر شبکه (Latency) | استفاده از Caching هوشمند در لایه مجازیسازی یا استراتژیهای «Data Mesh» که پردازش را به لبهها میبرد |
| ناهمگونی فرمتها | داده در AWS به صورت Parquet و در Azure SQL به صورت Row-based. لایه مجازیسازی وظیفه ترجمه (SerDe) را بر عهده میگیرد |
| تیمهای جزیرهای | تغییر ساختار از تیمهای «تکنولوژی-محور» به تیمهای «دامین-محور» |
| پیچیدگی عیبیابی | پیادهسازی «Distributed Tracing» (مثل OpenTelemetry) برای ردیابی جریان داده و خطاها |
مقاله داخلی ما با عنوان «Data Mesh چیست؟» میتواند در درک بهتر این چالشها کمک کند.
🔮 بخش ۱۰: آینده – حاکمیت داده خودران (Autonomous Data Governance) در حاکمیت داده در محیط چند-ابری
آینده حاکمیت داده در محیط چند-ابری با GenAI و Active Metadata گره خورده است.
سناریوهای آینده
| سناریو | توضیح |
|---|---|
| تکثیر خودکار (Auto-Replication) | سیستم متوجه میشود دیتاست در AWS پرطرفدار شده، پس به طور خودکار کپی (Replica) در Azure ایجاد میکند تا تاخیر کم و هزینه Egress کاهش یابد |
| قطع خودکار اتصال (Circuit Breaker) | اگر حمله سایبری در GCP تشخیص داده شود، سیستم به طور خودکار تمام اتصالات بین GCP و سایر ابرها را قطع میکند |
برای آشنایی با Active Metadata، وبلاگ DataHub را مطالعه کنید.
✅ بخش ۱۱: نتیجهگیری – چکلیست نهایی حاکمیت داده در محیط چند-ابری
حاکمیت داده در محیط چند-ابری، نبرد بین پیچیدگی و کنترل است.
📌 نکات کلیدی
| اصل | توضیح |
|---|---|
| پذیرش توزیعشدگی | تلاش برای متمرکز کردن فیزیکی دادهها شکست میخورد |
| راهحل | ایجاد یک لایه Logical Governance قدرتمند |
| معماری | Data Fabric + استانداردهای باز (OPA و OpenLineage) |
| آزادی تیمها | اجازه استفاده از بهترین ابزارها در هر ابر |
| ریلگذاری امنیتی | تضمین امنیت و شفافیت در پسزمینه |
🎯 تغییر پارادایم
| رویکرد قدیمی | رویکرد جدید |
|---|---|
| کنترل دروازهها (Gatekeeping) | محافظت از جادهها (Guardrails) |
💡 پیام نهایی: سازمانهای پیشرو به جای اینکه جلوی استفاده از ابرهای مختلف را بگیرند، با پیادهسازی معماری Data Fabric و استفاده از استانداردهای باز، به تیمهای خود اجازه میدهند آزادانه از بهترین ابزارها استفاده کنند، در حالی که «ریلگذاریهای امنیتی» و «شفافیت اطلاعاتی» در پسزمینه تضمین شده است. حاکمیت داده در محیط چند-ابری دیگر یک انتخاب نیست، بلکه پیشنیاز بقا در اقتصاد دیجیتال است.