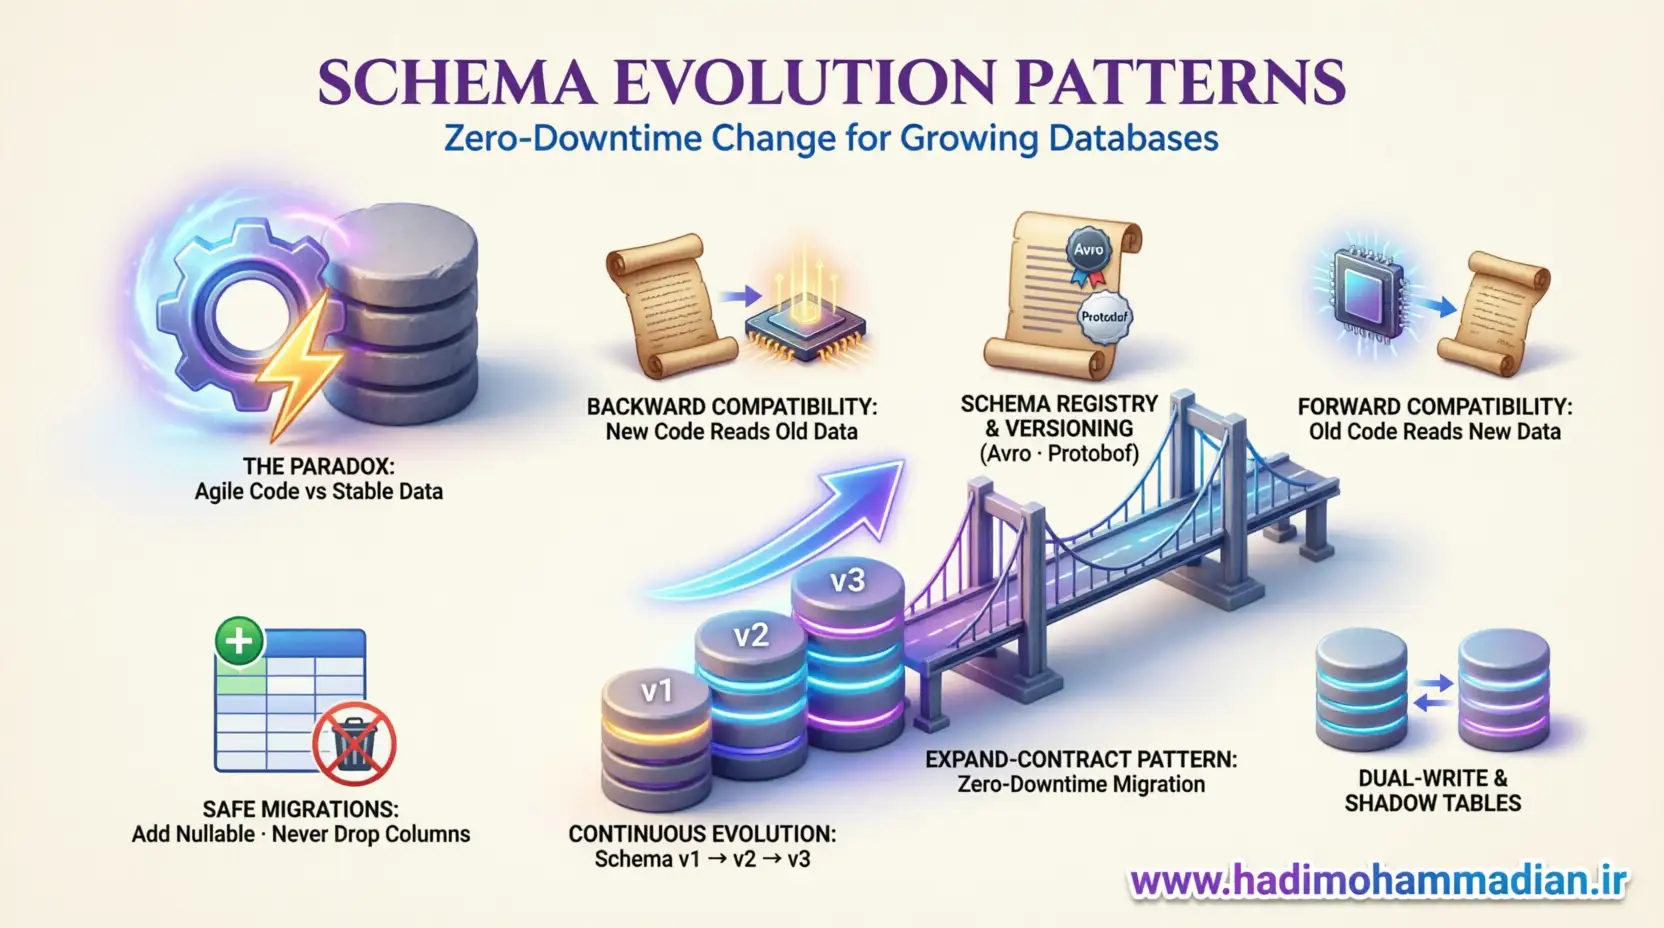
الگوهای Schema Evolution برای پایگاهدادههای در حال رشد: معماری تغییر بدون توقف
🔴 بخش ۱: مقدمه – پارادوکس پایداری و تغییر در الگوهای Schema Evolution
در قلب هر سیستم نرمافزاری مدرن، یک تضاد بنیادی وجود دارد: کد نرمافزار باید چابک (Agile) باشد و دائماً تغییر کند، اما دادهها میل به پایداری و سکون دارند. الگوهای Schema Evolution دقیقاً برای حل این تضاد طراحی شدهاند.
در متدولوژیهای مدرن توسعه نرمافزار (CI/CD)، ما عادت کردهایم که روزانه دهها بار کد را دیپلوی کنیم. این فرآیند به خوبی اتوماسیون شده و ریسک آن به حداقل رسیده است. اما وقتی نوبت به لایه پایگاهداده (Database Layer) میرسد، ترس بر تیم حاکم میشود. تغییر یک نام ستون، تغییر نوع داده، یا تقسیم یک جدول بزرگ میتواند منجر به قفل شدن جداول (Locking)، از دسترس خارج شدن سرویس (Downtime) و در بدترین حالت، از دست رفتن دادهها شود. الگوهای Schema Evolution این ترس را از بین میبرند.
الگوهای Schema Evolution هنر و علم مدیریت تغییرات ساختار پایگاهداده است، به گونهای که با تغییرات کد اپلیکیشن همگام باشد، بدون اینکه پایداری سیستم را به خطر بیندازد. در سیستمهای در حال رشد (Growing Databases)، رویکرد سنتی «پایین آوردن سرور، اجرای اسکریپت SQL و بالا آوردن سرور» دیگر قابل قبول نیست. ما نیاز به الگوهای Schema Evolution داریم که تغییرات را به صورت آنلاین و تدریجی اعمال کنند.
🔑 نکته کلیدی: در دنیای مدرن، Downtime یک گناه نابخشودنی است. کاربران انتظار دارند سرویسها همیشه در دسترس باشند، حتی در حین تغییرات ساختاری. الگوهای Schema Evolution این انتظار را برآورده میکنند.
🟠 بخش ۲: مفاهیم پایه در استراتژی تکامل الگوهای Schema Evolution
قبل از بررسی الگوهای Schema Evolution، باید سه مفهوم کلیدی را که ستون فقرات هر استراتژی مایگریشن (Migration) هستند، درک کنیم.
🔄 ۲.۱. سازگاری با عقب (Backward Compatibility) در الگوهای Schema Evolution
این حیاتیترین مفهوم در الگوهای Schema Evolution است. تغییر در Schema زمانی «سازگار با عقب» است که کد نسخه قدیمی اپلیکیشن (N-1) بتواند بدون خطا با دیتابیس نسخه جدید (N) کار کند.
| نوع تغییر | سازگاری | توضیح |
|---|---|---|
| ✅ اضافه کردن ستون Nullable | سازگار | کد قدیمی از آن خبر ندارد |
| ❌ حذف ستون | ناسازگار | کد قدیمی خطا میگیرد |
| ❌ تغییر نام ستون | ناسازگار | کد قدیمی ستون را پیدا نمیکند |
مثال امن: اضافه کردن یک ستون جدید که Nullable است. کد قدیمی اصلاً از وجود این ستون خبر ندارد و کارش را انجام میدهد.
مثال مخرب: حذف یک ستون یا تغییر نام آن. کد قدیمی سعی میکند ستون حذف شده را بخواند و با خطای SQL مواجه میشود.
⏩ ۲.۲. سازگاری با جلو (Forward Compatibility) در الگوهای Schema Evolution
تغییر زمانی «سازگار با جلو» است که کد نسخه جدید اپلیکیشن (N) بتواند با دیتابیس نسخه قدیمی (N-1) کار کند. این معمولاً زمانی رخ میدهد که شما ابتدا کد را دیپلوی میکنید و سپس دیتابیس را آپدیت میکنید.
💥 ۲.۳. تغییرات مخرب (Breaking Changes) در الگوهای Schema Evolution
هر تغییری که باعث شود نسخه فعلی اپلیکیشن از کار بیفتد. در سیستمهای «Zero Downtime»، هیچ تغییر مخربی مجاز نیست مگر اینکه طی یک فرآیند چند مرحلهای (Multi-phase) مدیریت شود. الگوهای Schema Evolution این فرآیند را تعریف میکنند.
🟡 بخش ۳: الگوی طلایی – Expand and Contract در الگوهای Schema Evolution (تغییر موازی)
این الگو که با نام Parallel Change نیز شناخته میشود، استاندارد طلایی الگوهای Schema Evolution برای انجام تغییرات مخرب (مثل تغییر نام ستون، تغییر نوع داده، یا جابجایی داده بین جداول) بدون Downtime است.
فلسفه: هرگز چیزی را که هنوز استفاده میشود حذف نکنید و هرگز چیزی را که هنوز وجود ندارد نخوانید.
📊 فازهای الگوی Expand and Contract در الگوهای Schema Evolution
| فاز | اقدام | وضعیت |
|---|---|---|
| 1️⃣ گسترش (Expand) | اضافه کردن ساختار جدید در کنار قدیمی | هر دو ستون وجود دارند |
| 2️⃣ نوشتن دوگانه (Dual Write) | نوشتن در هر دو ستون | خواندن از قدیمی |
| 3️⃣ پر کردن (Backfill) | انتقال دادههای تاریخی | هر دو ستون پر هستند |
| 4️⃣ تغییر خواندن (Switch Read) | خواندن از ستون جدید | نوشتن همچنان دوگانه |
| 5️⃣ انقباض (Contract) | حذف ستون قدیمی | فقط ستون جدید باقی میماند |
🎯 فاز ۱: گسترش (Expand) در الگوهای Schema Evolution
در این مرحله، ساختار جدید را اضافه میکنید، اما همچنان از ساختار قدیمی استفاده میکنید.
اقدام: اضافه کردن ستون جدید (مثلاً phone_number_v2) در کنار ستون قدیمی (phone_number).
وضعیت: دیتابیس هر دو ستون را دارد. اپلیکیشن فقط از ستون قدیمی میخواند و در آن مینویسد. ستون جدید باید Nullable باشد تا فرآیند ALTER TABLE سریع باشد.
🎯 فاز ۲: نوشتن دوگانه (Dual Write) در الگوهای Schema Evolution
کد اپلیکیشن را آپدیت میکنید تا در هر دو ستون بنویسد، اما همچنان از ستون قدیمی بخواند.
اقدام: تغییر لایه DAO/Repository. هر INSERT یا UPDATE باید هم phone_number و هم phone_number_v2 را پر کند.
نکته: این کار تضمین میکند که دادههای جدیدی که وارد میشوند، در فرمت جدید هم ذخیره میشوند.
🎯 فاز ۳: پر کردن دادههای پیشین (Backfill / Migration) در الگوهای Schema Evolution
اکنون باید دادههای تاریخی را از ستون قدیم به ستون جدید منتقل کنید.
اقدام: اجرای یک اسکریپت پسزمینه (Background Job) که رکوردهایی را که در ستون جدید NULL هستند پیدا کرده و مقدار ستون قدیم را در آن کپی میکند.
چالش: این فرآیند نباید دیتابیس را قفل کند. باید به صورت دستهای (Batch) و با سرعت کنترل شده (Throttling) انجام شود.
🎯 فاز ۴: تغییر خواندن (Switch Read) در الگوهای Schema Evolution
پس از اتمام Backfill و اطمینان از صحت دادهها، کد اپلیکیشن را تغییر میدهید تا از ستون جدید بخواند.
وضعیت: نوشتن همچنان دوگانه است (برای احتیاط و امکان Rollback سریع)، اما خواندن فقط از phone_number_v2 انجام میشود.
🎯 فاز ۵: انقباض (Contract) – پاکسازی در الگوهای Schema Evolution
پس از مدتی که مطمئن شدید همه چیز پایدار است، کدهای مربوط به ستون قدیمی و نهایتاً خود ستون قدیمی را از دیتابیس حذف میکنید.
اقدام: حذف لاجیک Dual Write و سپس اجرای ALTER TABLE DROP COLUMN phone_number.
🟢 بخش ۴: الگوی تغییر شِما به صورت آنلاین در الگوهای Schema Evolution (Online Schema Change – OSC)
در جداول بسیار بزرگ (چند صد میلیون یا میلیارد رکورد)، حتی یک دستور ساده ALTER TABLE ADD COLUMN میتواند باعث قفل شدن جدول برای ساعتها شود. الگوهای Schema Evolution این مشکل را با OSC حل میکنند.
🛠️ ابزارهای OSC در الگوهای Schema Evolution
| ابزار | توسعهدهنده | مکانیزم |
|---|---|---|
| 🔧 gh-ost | GitHub | Binary Logs |
| 🔧 pt-online-schema-change | Percona | Triggers |
🔄 مکانیزم جدول سایه (Shadow Table) در الگوهای Schema Evolution
این الگو به جای تغییر جدول اصلی، مراحل زیر را انجام میدهد:
| مرحله | اقدام |
|---|---|
| 1️⃣ ایجاد جدول روح | ساخت جدول جدید خالی شبیه جدول اصلی |
| 2️⃣ اعمال تغییر | ALTER TABLE روی جدول خالی (آنی) |
| 3️⃣ همگامسازی | کپی دادهها از جدول اصلی به جدول سایه |
| 4️⃣ ضبط تغییرات زنده | اعمال همزمان Insert/Update/Delete |
| 5️⃣ جایگزینی اتمیک | RENAME TABLE |
مزیت: جدول اصلی هرگز قفل نمیشود و سرویسدهی ادامه دارد.
مقاله داخلی ما با عنوان «Online Schema Change با gh-ost» را مطالعه کنید.
🔵 بخش ۵: الگوهای تکامل در NoSQL و Schema-on-Read در الگوهای Schema Evolution
پایگاههای داده NoSQL (مانند MongoDB یا Cassandra) اغلب به عنوان «Schemaless» تبلیغ میشوند. این یک دروغ بزرگ است. دادهها همیشه ساختار دارند، اما این ساختار به جای اینکه در دیتابیس (Schema-on-Write) اعمال شود، در کد اپلیکیشن (Schema-on-Read) مدیریت میشود. الگوهای Schema Evolution برای NoSQL نیز ضروری هستند.
📄 ۵.۱. الگوی نسخهبندی سند (Document Versioning Pattern) در الگوهای Schema Evolution
در دیتابیسهای سند-گرای مثل MongoDB، بهترین راه برای مدیریت تغییرات در الگوهای Schema Evolution، اضافه کردن فیلد schema_version به هر سند است.
// سند قدیمی (Version 1)
{
  "_id": "101",
  "name": "Ali",
  "address": "Tehran, Valiasr St",
  "schema_version": 1
}

// سند جدید (Version 2)
{
  "_id": "102",
  "name": "Reza",
  "address": {
    "city": "Tehran",
    "street": "Azadi"
  },
  "schema_version": 2
}
مدیریت در کد در الگوهای Schema Evolution:
| مرحله | اقدام |
|---|---|
| 1️⃣ | لایه اپلیکیشن هنگام خواندن، ورژن را چک میکند |
| 2️⃣ | اگر ورژن ۱ بود → تبدیل به ساختار ورژن ۲ |
| 3️⃣ | اگر ورژن ۲ بود → استفاده مستقیم |
Lazy Migration: میتوانیم در همان لحظه خواندن، سند تبدیل شده را دوباره ذخیره کنیم تا به مرور همه دادهها به ورژن جدید مهاجرت کنند.
🟣 بخش ۶: الگوی انتزاع با View (View-Based Abstraction) در الگوهای Schema Evolution
این الگو یک لایه انتزاعی بین جداول فیزیکی و اپلیکیشن ایجاد میکند. این روش در الگوهای Schema Evolution سازمانی بزرگ بسیار محبوب است.
نحوه عملکرد در الگوهای Schema Evolution:
| اصل | توضیح |
|---|---|
| 🚫 عدم دسترسی مستقیم | اپلیکیشن هرگز مستقیم به جداول دسترسی ندارد |
| ✅ استفاده از View | اپلیکیشن فقط با Views و Stored Procedures کار میکند |
| 🔄 تغییر شفاف | ساختار جدول تغییر میکند اما View همان خروجی را میدهد |
| مزیت | عیب |
|---|---|
| ✅ جداسازی کامل لایه داده | ❌ پیچیدگی بالا |
| ✅ تغییر شفاف برای اپلیکیشن | ❌ مشکلات پرفورمنس در Viewهای پیچیده |
🟤 بخش ۷: میکروسرویسها و پایگاهداده مشترک در الگوهای Schema Evolution (Shared Database Anti-pattern)
در معماری میکروسرویس، یکی از بدترین ضدالگوها، استفاده چند سرویس از یک دیتابیس مشترک است. این کار الگوهای Schema Evolution را کابوس میکند.
🏝️ الگوی Database-per-Service در الگوهای Schema Evolution
| اصل | توضیح |
|---|---|
| 📊 دیتابیس جداگانه | هر سرویس دیتابیس مستقل دارد |
| 🚫 ممنوعیت SELECT مستقیم | دسترسی فقط از طریق API |
| ✅ آزادی تغییر | ساختار داخلی را آزادانه تغییر دهید |
💡 نکته: اگر سرویس B به دادههای سرویس A نیاز دارد، باید از طریق API یا رویدادها (Events) داده را دریافت کند.
⚫ بخش ۸: ابزارها و اتوماسیون (Database as Code) در الگوهای Schema Evolution
مدیریت دستی تغییرات (sql fileهایی که توسط انسان اجرا میشوند) منشاء خطاست. تغییرات دیتابیس باید مثل کد مدیریت شوند. الگوهای Schema Evolution با Database as Code کامل میشوند.
🛠️ ابزارهای Migration در الگوهای Schema Evolution
Versioning: هر تغییر دیتابیس یک فایل (مثلاً V1__init.sql, V2__add_column.sql) است.
Checksum: ابزار یک جدول متادیتا نگه میدارد و هش هر فایل اجرا شده را ذخیره میکند. اگر کسی فایل مایگریشن قبلی را تغییر دهد، پایپلاین CI/CD خطا میدهد.
Idempotency: این ابزارها تضمین میکنند که هر اسکریپت فقط یک بار اجرا میشود.
📊 استراتژی CI/CD در الگوهای Schema Evolution
| مرحله | اقدام |
|---|---|
| 1️⃣ توسعه | فایل مایگریشن در کنار کد کامیت میشود |
| 2️⃣ CI | اجرای مایگریشن روی دیتابیس موقت |
| 3️⃣ CD | اجرای مایگریشن قبل از دیپلوی اپلیکیشن |
✅ بخش ۹: چالشهای خاص و راهکارها در الگوهای Schema Evolution
📊 ۹.۱. مدیریت ستونهای Not Null در الگوهای Schema Evolution
اضافه کردن یک ستون NOT NULL به جدول پر از داده غیرممکن است.
| راهکار | توضیح |
|---|---|
| 1️⃣ | ابتدا NULL بسازید، پر کنید، سپس SET NOT NULL |
| 2️⃣ | استفاده از DEFAULT value (در PG 11+ و MySQL 8 بهینه) |
🔄 ۹.۲. تغییر نام جداول/ستونها (Renaming) در الگوهای Schema Evolution
تغییر نام در SQL ساده است اما در عمل سختترین کار است.
راهکار: استفاده از الگوی View. یک View با نام قدیمی بسازید که به جدول با نام جدید اشاره میکند.
📊 جدول چالشها و راهکارها در الگوهای Schema Evolution
| چالش | راهکار |
|---|---|
| 📊 Not Null | Backfill + SET NOT NULL |
| 🔄 Renaming | View-Based Abstraction |
| 🔒 Locking | Online Schema Change |
| 💥 Breaking Changes | Expand and Contract |
✅ نتیجهگیری: چکلیست نهایی الگوهای Schema Evolution
تکامل طرحواره (الگوهای Schema Evolution) در سیستمهای مقیاسبالا، دیگر یک وظیفه جانبی برای ادمین دیتابیس نیست؛ بلکه بخشی جداییناپذیر از فرآیند توسعه نرمافزار است.
📌 اصول کلیدی موفقیت در الگوهای Schema Evolution
| اصل | توضیح |
|---|---|
| ⚡ ذهنیت Zero-Downtime | هیچ تغییری نباید سرویس را قطع کند |
| 🔄 Expand and Contract | برای تغییرات ساختاری |
| 📦 ورژنگذاری | Database as Code |
| 🏝️ جداسازی | Database-per-Service |
💡 پیام نهایی: پایگاهداده شما یک موجود زنده است؛ به جای ساختن قفسی سنگی در اطراف آن، با الگوهای Schema Evolution به آن اجازه دهید تا رشد کند و تکامل یابد.