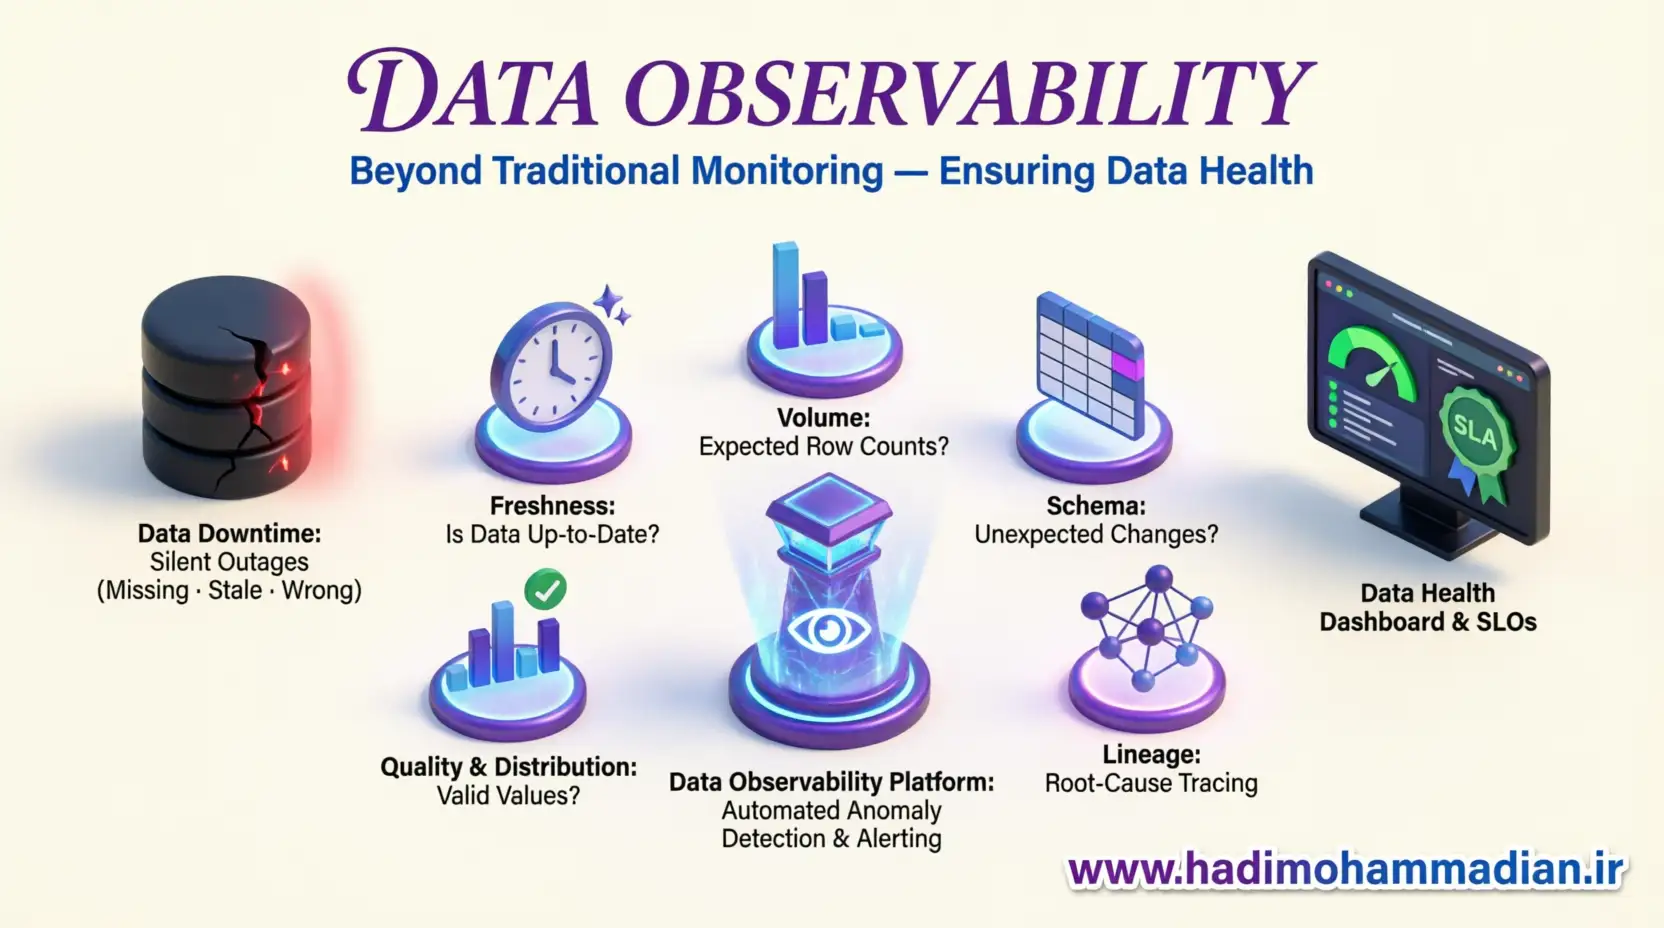
چارچوبهای Observability داده: فراتر از مانیتورینگ سنتی و تضمین سلامت دادهها
🔴 بخش ۱: مقدمه – بحران خاموش «Data Downtime» در Observability داده
در دنیای مهندسی نرمافزار، مفاهیمی مانند APM (Application Performance Monitoring) و Observability (با ابزارهایی مثل Datadog یا New Relic) سالهاست که استاندارد شدهاند. اگر وبسایت شما کند شود یا سرور از کار بیفتد، مهندسان بلافاصله مطلع میشوند. اما در دنیای داده، داستان متفاوت است. Observability داده دقیقاً برای حل این چالش ظهور کرده است.
اغلب اوقات، پایپلاینهای داده به صورت «خاموش» میشکنند. هیچ سروری کرش نمیکند، هیچ خطای 500 بازگردانده نمیشود. این شکست خاموش از این جهت خطرناک است که میتواند ساعتها یا حتی روزها بدون شناسایی ادامه یابد و در این مدت، تصمیمات تجاری بر اساس دادههای نادرست اتخاذ شوند. Observability داده این شکستهای خاموش را شناسایی میکند.
| نشانه شکست خاموش | توضیح |
|---|---|
| 🔍 فیلد NULL | فیلدی که نباید NULL شود، NULL شده |
| 📊 Data Drift | توزیع دادهها تغییر کرده |
| ⏱️ داده قدیمی | داشبورد اعداد دیروز را نشان میدهد |
این وضعیت را Data Downtime مینامند؛ دورههایی که دادهها ناقص، اشتباه یا گم شده هستند. مانیتورینگ سنتی دیگر برای مقابله با پیچیدگی سیستمهای داده مدرن کافی نیست. ما نیاز به Observability داده داریم.
🔑 نکته کلیدی: Data Downtime مانند یک بیماری خاموش است که بدون علائم ظاهری، سلامت سیستم را از درون تخریب میکند. Observability داده سیستم ایمنی است که این بیماری را در مراحل اولیه تشخیص میدهد.
🟠 بخش ۲: تفاوت بنیادین – مانیتورینگ در برابر Observability داده
برای درک معماری Observability داده، ابتدا باید تمایز فلسفی آن را با مانیتورینگ درک کنیم. این تفاوت نه فقط در ابزار، بلکه در رویکرد و فلسفه است.
📊 مانیتورینگ (Monitoring): آیا چراغها روشن هستند؟
مانیتورینگ به شما میگوید چه زمانی مشکلی پیش آمده است، اما فقط مشکلاتی را میبیند که شما از قبل پیشبینی کردهاید و برای آنها تست نوشتهاید.
| جنبه | توضیح |
|---|---|
| 🎯 رویکرد | «Unknowns Known» (ناشناختههای شناخته شده) |
| 📝 مثال | تست id نباید null باشد |
| ⚠️ محدودیت | تغییر توزیع price را تشخیص نمیدهد |
محدودیت: اگر توزیع دادههای ستون price ناگهان تغییر کند و همه قیمتها ۱۰ برابر شوند، تست not null پاس میشود، اما دادهها کاملاً غلط هستند.
🔭 رویتپذیری (Observability داده): چرا چراغها خاموش شدند؟
Observability داده به شما میگوید چرا مشکلی پیش آمده و وضعیت سلامت سیستم را با بررسی خروجیهای آن (Logs, Metrics, Traces) درک میکند، حتی برای مشکلاتی که هرگز پیشبینی نمیکردید.
| جنبه | توضیح |
|---|---|
| 🎯 رویکرد | «Unknown Unknowns» (ناشناختههای ناشناخته) |
| 📝 مثال | تشخیص خودکار کاهش ۳۰٪ حجم داده |
| ✅ مزیت | بدون نیاز به نوشتن قانون دستی |
💡 نکته: مانیتورینگ میگوید «سرور خوابیده است»؛ Observability داده میگوید «چرا سرور خوابیده و چه کسانی تحت تاثیر هستند.»
🟡 بخش ۳: پنج ستون اصلی Observability داده
یک چارچوب جامع Observability داده باید بر روی پنج ستون استوار باشد که سلامت داده را تضمین میکنند. این مدل اغلب توسط پیشگامان این حوزه (مانند Monte Carlo Data) استاندارد شده است:
⏱️ ۳.۱. تازگی (Freshness) در Observability داده
آیا دادهها در زمان مورد انتظار آپدیت شدهاند؟
چالش: پایپلاین Airflow با موفقیت اجرا شده (سبز است)، اما دادهای در جداول نهایی بارگذاری نشده است.
راهکار: ردیابی زمان آخرین آپدیت جداول و مقایسه آن با الگوهای تاریخی (Historical Patterns) در Observability داده.
📊 ۳.۲. توزیع (Distribution) در Observability داده
آیا دادهها در سطح فیلد (Field-level) منطقی هستند؟
| معیار | توضیح |
|---|---|
| 📊 نرخ Null | درصد مقادیر NULL |
| 📈 آمار توصیفی | میانگین، مینیمم، ماکزیمم |
| 🔢 توزیع Enum | مقادیر دستهای |
مثال: اگر درصد کاربران «iOS» همیشه ۶۰٪ بوده و ناگهان به ۵٪ برسد، یک مشکل جدی در جمعآوری داده وجود دارد. Observability داده این تغییر را تشخیص میدهد.
📦 ۳.۳. حجم (Volume) در Observability داده
آیا تمام دادهها رسیدهاند؟
بررسی: تعداد رکوردها (Row Count) در جداول و فایلها. آیا امروز ۱ میلیون رکورد دریافت کردیم در حالی که معمولاً ۱۰ میلیون رکورد داشتیم؟ یا برعکس (تکرار داده)؟
📋 ۳.۴. طرحواره (Schema) در Observability داده
آیا ساختار داده تغییر کرده است؟
| تغییر | توضیح |
|---|---|
| 🔴 حذف ستون | عامل شماره یک شکست پایپلاین |
| 🔴 تغییر نوع | از String به Integer |
| 🔴 تغییر نام | توسط تیمهای Upstream |
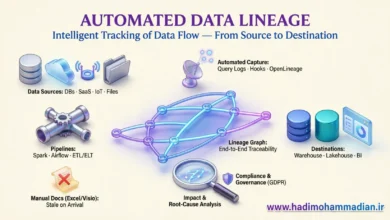
🔗 ۳.۵. اصل و نسب (Lineage) در Observability داده
اگر مشکلی هست، از کجا آمده و چه کسی را تحت تاثیر قرار میدهد؟
نقشه کامل: داده از کدام سرویس آمده، وارد کدام جدول شده، چه ویوهایی ساخته شده و نهایتاً در کدام داشبورد Tableau یا Looker نمایش داده میشود.
📊 جدول پنج ستون Observability داده
| ستون | سوال | تشخیص |
|---|---|---|
| ⏱️ Freshness | آپدیت شد؟ | تاخیر در بارگذاری |
| 📊 Distribution | منطقی است؟ | تغییر توزیع |
| 📦 Volume | کامل رسید؟ | کمبود یا تکرار |
| 📋 Schema | ساختار تغییر کرد؟ | Breaking Change |
| 🔗 Lineage | از کجا آمد؟ | تحلیل ریشه |
🟢 بخش ۴: معماری فنی یک پلتفرم Observability داده
چگونه چنین سیستم پیچیدهای را پیادهسازی کنیم؟ معماری Observability داده معمولاً از سه لایه تشکیل شده است:
📥 لایه ۱: جمعآوری متادیتا (Metadata Extraction) در Observability داده
برخلاف ابزارهای مانیتورینگ قدیمی که نیاز به نصب Agent سنگین داشتند، پلتفرمهای مدرن Observability داده معمولاً بدون Agent (Agentless) هستند و فقط به متادیتا متصل میشوند، نه خودِ داده (برای حفظ امنیت و حریم خصوصی).
| منبع | توضیح |
|---|---|
| 🗄️ Warehouse Logs | INFORMATION_SCHEMA و QUERY_HISTORY |
| ⚙️ Orchestrator Logs | Airflow یا Dagster |
| 📊 BI Tools | Tableau/Looker برای Lineage |
🧠 لایه ۲: موتور تشخیص ناهنجاری (Anomaly Detection Engine) در Observability داده
این مغز متفکر سیستم Observability داده است. به جای اینکه کاربر هزاران قانون استاتیک بنویسد، از یادگیری ماشین استفاده میشود:
| فاز | اقدام |
|---|---|
| 📚 Learning Phase | یادگیری رفتار «نرمال» در چند هفته |
| 📊 Dynamic Thresholds | آستانههای متغیر بر اساس Seasonality |
Seasonality Awareness: سیستم میفهمد که در «روزهای تعطیل» حجم داده کم است، پس هشدار بیمورد نمیفرستد.
⚡ لایه ۳: لایه اقدام و هشدار (Action & Alerting) در Observability داده
| اقدام | توضیح |
|---|---|
| 📨 هشدار | Slack/Teams/PagerDuty |
| 📊 Context | کدام جدول؟ چه تغییری؟ |
| 🛡️ Circuit Breaking | توقف پایپلاینهای بعدی |
برای مطالعه بیشتر درباره Monte Carlo، وبسایت رسمی Monte Carlo Data را ببینید.
مقاله داخلی ما با عنوان «Anomaly Detection در دادهها» را مطالعه کنید.
🔵 بخش ۵: مقایسه – تست داده (Data Testing) در مقابل Observability داده
بسیاری از تیمها تصور میکنند چون از dbt test یا Great Expectations استفاده میکنند، نیاز به Observability داده ندارند. این تصور اشتباه است.
📊 جدول مقایسه Data Testing و Observability داده
| ویژگی | 🧪 DATA TESTING | 🔭 OBSERVABILITY داده |
|---|---|---|
| ماهیت | فعال (Active) | غیرفعال (Passive) |
| پوشش | Known Knowns | Unknown Unknowns |
| نگهداری | بالا | پایین (ML خودکار) |
| هدف | جلوگیری از ورود | درک سلامت کلی |
| تحلیل ریشه | ندارد | دارد (Lineage) |
💡 استراتژی برتر: استفاده ترکیبی. تستها برای قوانین حیاتی بیزنس و Observability داده برای سلامت عمومی سیستم.
مقاله داخلی ما با عنوان «Data Testing با Great Expectations» را مطالعه کنید.
🟣 بخش ۶: پیادهسازی – ساختن یا خریدن؟ (Build vs. Buy) در Observability داده
🏗️ گزینه ۱: ساختن (Open Source & Custom) برای Observability داده
| ابزار | نقش |
|---|---|
| 🔗 OpenLineage | استخراج Lineage |
| 🧪 Great Expectations | تست و متریک |
| 📊 Grafana | داشبورد |
چالش: ساخت موتور Anomaly Detection با نویز کم (Low False Positive) بسیار دشوار و پیچیده است.
☁️ گزینه ۲: پلتفرمهای تجاری (Enterprise Platforms) برای Observability داده
| ابزار | ویژگی |
|---|---|
| 🏆 Monte Carlo | پیشگام صنعت |
| 📊 Bigeye | کامل و قدرتمند |
| 📈 Datadog | یکپارچه با APM |
| 📊 Metaplane | سبک و سریع |
مزیت: Plug-and-play هستند و معمولاً ظرف چند ساعت روی Warehouse شما سوار میشوند.
برای مطالعه بیشتر درباره OpenLineage، مستندات OpenLineage را ببینید.
🟤 بخش ۷: کاربرد پیشرفته – تحلیل ریشه (Root Cause Analysis – RCA) در Observability داده
قدرت واقعی Observability داده در زمانی مشخص میشود که ساعت ۳ صبح هشداری دریافت میکنید. یک سیستم خوب RCA به شما کمک میکند:
| سوال | قابلیت |
|---|---|
| 🔄 همبستگی | آیا همزمان تغییری در کد رخ داده؟ |
| 📊 تاثیر | کدام داشبوردها متاثرند؟ |
| 🔍 منشاء | از همان ابتدا خراب بود؟ |
همبستگی (Correlation): آیا همزمان با خراب شدن این جدول، تغییری در کدهای dbt یا Airflow رخ داده است؟ (Integration with Git)
تاثیر (Impact Analysis): کدام داشبوردهای مدیریتی از این جدول تغذیه میکنند؟ آیا باید به مدیر مالی اطلاع دهم؟
منشاء (Upstream Issue): آیا داده از همان ابتدای ورود خراب بوده یا در لایه Transformation خراب شده است؟
⚫ بخش ۸: آینده – مهندسی قابلیت اطمینان داده (Data Reliability Engineering – DRE) در Observability داده
ظهور چارچوبهای Observability داده منجر به ایجاد نقش جدیدی به نام DRE شده است.
📊 مسئولیتهای DRE در Observability داده
| مسئولیت | توضیح |
|---|---|
| 🎯 تعریف SLO | دادههای مالی تا ساعت ۹ صبح با ۹۹.۹٪ صحت |
| 🚨 Incident Response | مدیریت حوادث داده |
| ⚡ کاهش MTTD/MTTR | زمان تشخیص و رفع خطا |
✅ بخش ۹: نتیجهگیری – چکلیست نهایی Observability داده
دادهها امروزه به اندازه کدهای نرمافزاری حیاتی هستند، اما ابزارهای مدیریت آنها دههها عقبتر بودهاند. چارچوبهای Observability داده تلاشی برای پر کردن این شکاف هستند.
📌 نکات کلیدی موفقیت در Observability داده
| اصل | توضیح |
|---|---|
| 🔭 گذار به Observability | از قانون دستی به ML خودکار |
| 📊 پنج ستون | Freshness, Distribution, Volume, Schema, Lineage |
| 🧪 ترکیب با Testing | قوانین حیاتی + سلامت عمومی |
| 🔍 RCA | تحلیل ریشه با Lineage |
💡 پیام نهایی: سرمایهگذاری روی Observability داده هزینه نیست؛ بیمهای است برای تصمیمگیریهای حیاتی سازمان که بر اساس دادهها اتخاذ میشوند. با گذار از «مانیتورینگ دستی» به «رویتپذیری هوشمند»، سازمانها میتوانند اعتماد از دست رفته به دادهها را بازگردانند.