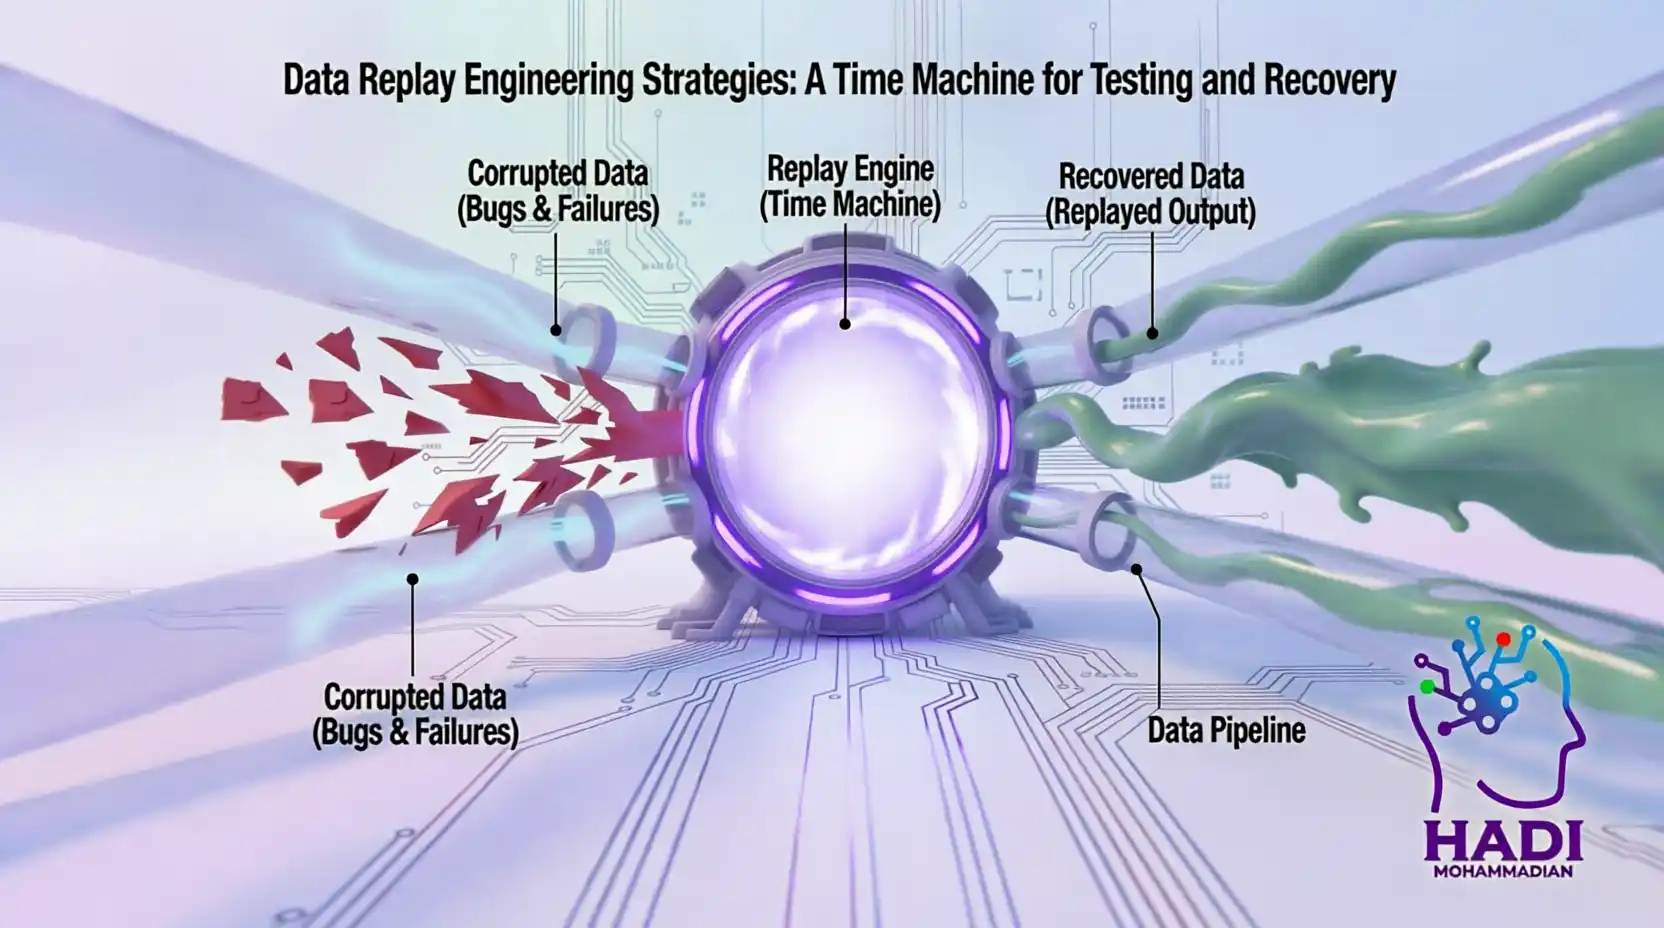
استراتژیهای مهندسی بازپخش داده (Replay): ماشین زمان برای تست و بازیابی
🔴 بخش ۱: مقدمه – نیاز به ماشین زمان در بازپخش داده
در دنیای ایدهآل، پایپلاینهای داده همیشه درست کار میکنند، کدهای ما بدون باگ هستند و نیازمندیهای بیزینس هرگز تغییر نمیکنند. اما در واقعیت، باگهای منطقی کشف میشوند، دادهها فاسد میشوند، و مدلهای یادگیری ماشین نیاز به بازآموزی با دادههای تاریخی دارند. بازپخش داده دقیقاً برای حل این چالشها طراحی شده است.
این واقعیتها باعث میشوند که توانایی «بازگشت به گذشته» و پردازش مجدد دادهها به یک قابلیت حیاتی تبدیل شود. بدون این توانایی، هر باگ در کد پردازش داده میتواند منجر به از دست رفتن دائمی دادههای ارزشمند شود.
بازپخش داده (Data Replay) فرآیند پردازش مجدد دادههای تاریخی از طریق یک پایپلاین (یا نسخهای تغییر یافته از آن) است. این قابلیت برای دو هدف اصلی حیاتی است:
| هدف | توضیح | نمونه |
|---|---|---|
| 🔄 بازیابی (Recovery) | اصلاح دادههای خراب پس از رفع باگ | اصلاح گزارش مالی اشتباه |
| 🧪 تست (Testing) | بررسی صحت کد جدید با داده واقعی | تست فیچر جدید با داده بلک فرایدی |
🔑 نکته کلیدی: بازپخش داده مانند ماشین زمان است — به شما اجازه میدهد به گذشته برگردید، اشتباهات را اصلاح کنید و سناریوهای مختلف را آزمایش کنید.
🟠 بخش ۲: پیشنیازهای معماری برای بازپخش داده (Replayپذیری)
قبل از صحبت درباره استراتژیهای بازپخش داده، باید مطمئن شویم سیستم ما قابلیت بازپخش را دارد. بدون این سه ستون، بازپخش غیرممکن یا خطرناک است:
📥 ۲.۱. منبع داده تغییرناپذیر (Immutable Source) در بازپخش داده
شما نمیتوانید چیزی را بازپخش کنید که دور ریختهاید. این اصل بنیادین، اساس هر سیستم بازپخش داده است.
| استراتژی | توضیح |
|---|---|
| 📝 Log Retention | سیاست نگهداری کافی در Kafka (۷+ روز) |
| 💾 Tiered Storage | ذخیره دادههای خام در Data Lake (S3/GCS) |
Log Retention: در سیستمهایی مثل Kafka، سیاست نگهداری باید به اندازه کافی طولانی باشد. اگر دادهها پس از ۲۴ ساعت حذف شوند، امکان بازپخش داده طولانیمدت وجود ندارد.
Tiered Storage: برای بازپخشهای طولانی مدت (ماهها)، استفاده از قابلیت Tiered Storage کافکا یا ذخیره دادههای خام در Data Lake ضروری است. این رویکرد امکان بازپخش داده چند ماه قبل را فراهم میکند.
⏰ ۲.۲. زمان رخداد در مقابل زمان پردازش در بازپخش داده (Event Time vs. Processing Time)
این مهمترین مفهوم در بازپخش داده است.
| نوع زمان | توضیح | در بازپخش |
|---|---|---|
| ⏰ Event Time | زمان واقعی رخداد | ✅ نتایج Deterministic |
| ⚙️ Processing Time | زمان سیستم سرور | ❌ نتایج متفاوت |
اگر منطق شما بر اساس Processing Time باشد، بازپخش داده نتایج متفاوتی نسبت به اجرای اولیه خواهد داشت. پایپلاین باید اکیداً بر اساس Event Time طراحی شود تا نتایج قطعی (Deterministic) باشند.
🔄 ۲.۳. تکرارپذیری امن (Idempotency) در بازپخش داده
اجرای مجدد نباید باعث ایجاد رکوردهای تکراری یا تغییر نادرست وضعیت شود.
راهکار: سیستم باید بتواند تشخیص دهد که این داده قبلاً پردازش شده یا طوری طراحی شود که اعمال چندباره آن بیخطر باشد (مثل استفاده از UPSERT به جای INSERT).
برای مطالعه بیشتر درباره Kafka Retention، مستندات Apache Kafka را ببینید.
مقاله داخلی ما با عنوان «Idempotency در پایپلاینهای داده» را مطالعه کنید.
🟡 بخش ۳: استراتژیهای بازپخش داده برای بازیابی (Recovery)
وقتی دادهها به دلیل باگ خراب شدهاند، چگونه آنها را اصلاح کنیم؟ بازپخش داده چند استراتژی برای این منظور ارائه میدهد.
📊 ۳.۱. استراتژی بازنشانی آفست (Offset Reset Strategy) در بازپخش داده
سادهترین و خشنترین روش بازپخش داده.
روش: Consumer Group را متوقف کنید و Offset آن را به زمان قبل از شروع خرابی برگردانید (kafka-consumer-groups --reset-offsets).
| جنبه | توضیح |
|---|---|
| ✅ مزایا | ساده، بدون نیاز به زیرساخت اضافی |
| ❌ معایب | Downtime، تداخل دادههای اصلاح شده با خراب |
🏗️ ۳.۲. استراتژی پایپلاین موازی (Parallel/Shadow Pipeline) در بازپخش داده
روش استاندارد بازپخش داده برای سیستمهای حیاتی.
روش: یک نسخه جدید از پایپلاین (نسخه ۲) را بالا میآورید که از یک Group ID جدید استفاده میکند و از نقطه شروع مورد نظر شروع به خواندن میکند.
| مرحله | اقدام |
|---|---|
| 1️⃣ | نسخه ۲ دادههای تاریخی را پردازش میکند |
| 2️⃣ | نتایج در جدول/تاپیک جدید نوشته میشود |
| 3️⃣ | وقتی به زمان حال رسید، ترافیک سوئیچ میشود |
| 4️⃣ | نسخه ۱ خاموش میشود |
| جنبه | توضیح |
|---|---|
| ✅ مزایا | بدون Downtime، ایزولاسیون کامل |
| ❌ معایب | هزینه زیرساخت دو برابر |
📦 ۳.۳. استراتژی Backfill از دریاچه داده در بازپخش داده
اگر دادهها در Kafka منقضی شده باشند، باید از Data Lake استفاده کنید.
روش: یک جاب Spark (Batch) روی دادههای S3 اجرا میشود و نتایج را مستقیماً به دیتابیس سرویسدهنده تزریق میکند یا آنها را به یک تاپیک Kafka جدید پمپاژ میکند.
📊 جدول مقایسه استراتژیهای Recovery در بازپخش داده
| استراتژی | DOWNTIME | هزینه | پیچیدگی |
|---|---|---|---|
| ⚡ Offset Reset | دارد | کم | کم |
| 🏗️ Shadow Pipeline | ندارد | زیاد | متوسط |
| 📦 Backfill | ندارد | متوسط | متوسط |
🟢 بخش ۴: استراتژیهای بازپخش داده برای تست (Testing)
چگونه مطمئن شویم کد جدید روی دادههای واقعی درست کار میکند؟ بازپخش داده این امکان را فراهم میکند.
🪞 ۴.۱. آینهکردن ترافیک (Traffic Mirroring / Teeing) در بازپخش داده
مناسب برای تست بار (Load Test) و مقایسه خروجی.
روش: کپی کردن جریان دادههای زنده به یک محیط استیجینگ.
ابزار: MirrorMaker 2 در کافکا یا قابلیتهای Service Mesh (مانند Istio).
کاربرد: اجرای کد جدید با ورودیهای واقعی و مقایسه خروجی آن با سیستم قدیمی (Diffing).
🏝️ ۴.۲. محیطهای ایزوله (Sandbox Replay) در بازپخش داده
روش: توسعهدهنده یک بازه زمانی خاص از دادههای تولید را انتخاب میکند (مثلاً «دادههای بلک فرایدی پارسال»). این دادهها در یک محیط ایزوله بازپخش میشوند.
⚠️ نکته کلیدی: در این روش حتماً باید Side Effectها مدیریت شوند.
🔵 بخش ۵: چالش حیاتی – مدیریت عوارض جانبی (Side Effects) در بازپخش داده
بزرگترین خطر در بازپخش داده، تکرار عوارض جانبی بیرونی است.
مثال: پایپلاین شما پس از پردازش سفارش، یک ایمیل تایید برای مشتری میفرستد. اگر دادههای هفته گذشته را بازپخش کنید، مشتریان دوباره ایمیل دریافت میکنند!
📊 راهکارهای مدیریت Side Effects در بازپخش داده
| راهکار | توضیح |
|---|---|
| 🏷️ فلگ Dry-Run | is_replay=true → عملیات واقعی انجام نشود |
| 🏝️ Sinkهای ایزوله | اتصال به Mock SMTP به جای سرور واقعی |
| 🏗️ معماری Functional Core | جداسازی منطق محاسباتی از IO |
معماری Functional Core, Imperative Shell: منطق بیزنس (محاسبات) را از منطق اثرگذار (IO/Email) جدا کنید. بازپخش داده فقط لایه محاسباتی را درگیر میکند.
🟣 بخش ۶: مدیریت State در پردازش جریانی در بازپخش داده (Stateful Stream Replay)
در فریمورکهایی مثل Apache Flink یا Spark Structured Streaming، بازپخش داده پیچیدهتر است زیرا سیستم دارای «حافظه» (State) است.
📊 سناریو: تغییر منطق کد (Logic Change) در بازپخش داده
فرض کنید نحوه محاسبه «میانگین خرید کاربر» را تغییر دادهاید. نمیتوانید صرفاً کد جدید را روی State قدیمی سوار کنید، زیرا State با منطق قبلی ساخته شده است.
| راهکار | توضیح |
|---|---|
| 1️⃣ Bootstrap from Scratch | دور ریختن State و بازپخش کامل |
| 2️⃣ State Processor API | خواندن Savepoint قدیمی و Migrate |
راهکار ۱: State را دور بریزید و استریم را از «آغاز زمان» با کد جدید بازپخش کنید تا State جدید ساخته شود.
راهکار ۲: در Flink، از API پردازش State استفاده کنید تا فایل Savepoint قدیمی را بخوانید، آن را تغییر دهید و متناسب با کد جدید اصلاح کنید.
برای مطالعه بیشتر درباره State Management در Flink، مستندات Apache Flink را ببینید.
مقاله داخلی ما با عنوان «State Management در Flink» را مطالعه کنید.
✅ بخش ۷: نتیجهگیری – بازپخش داده به عنوان یک ویژگی، نه یک هک
مهندسی بازپخش داده نباید یک فکر ثانویه (Afterthought) برای روز مبادا باشد. پایپلاینهای داده بالغ، «قابلیت بازپخش» را به عنوان یکی از ویژگیهای اصلی معماری خود دارند.
📋 چکلیست طراحی برای بازپخش داده
✅ آیا تمام ورودیها دارای Timestamp رخداد هستند؟
✅ آیا عملیات نوشتن Idempotent است؟
✅ آیا میتوانیم خروجیهای جانبی (ایمیل/API) را در حالت بازپخش غیرفعال کنیم؟
✅ آیا دادههای خام به مدت کافی نگهداری میشوند؟
📊 جدول اصول کلیدی در بازپخش داده
| اصل | توضیح |
|---|---|
| ⏰ Event Time | نتایج Deterministic |
| 🔄 Idempotency | بدون داده تکراری |
| 🏷️ Dry-Run Flag | مدیریت Side Effects |
| 💾 Immutable Source | حفظ دادههای خام |
💡 پیام نهایی: با رعایت این اصول، سیستم بازپخش داده شما نه تنها در برابر خطا مقاوم میشود، بلکه بستری قدرتمند برای نوآوری و تست سریع ایدههای جدید فراهم میکند.