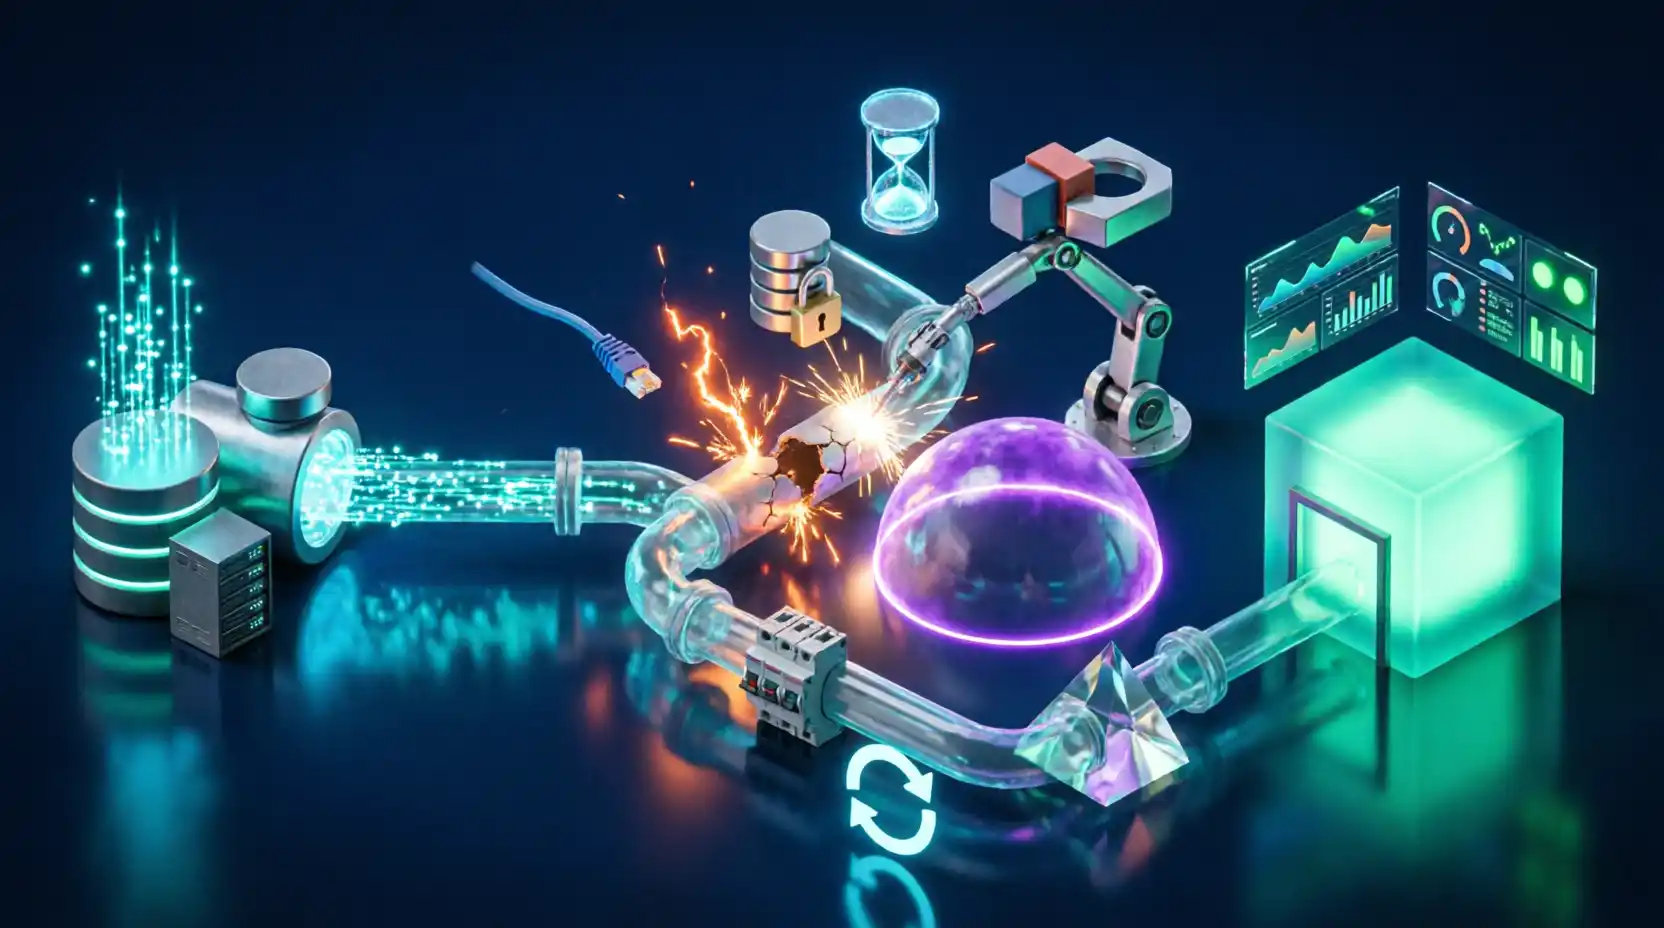
الگوهای طراحی Pipeline داده مقاوم برای سیستمهای تحملپذیر خطا
در مهندسی داده، قانون مورفی همیشه حاکم است: «هر چیزی که بتواند خراب شود، خراب خواهد شد.» شبکهها قطع میشوند، دیتابیسها قفل میکنند، APIها تایماوت میدهند و اسکیماهای داده بدون اطلاع قبلی تغییر میکنند. تفاوت یک پایپلاین داده شکننده با یک Pipeline داده مقاوم در نحوه برخورد با این خطاهاست.
این خطاها در سیستمهای توزیعشده نه تنها استثنا نیستند، بلکه قاعده هستند. هر سیستم توزیعشده با دهها یا صدها نود، به طور مداوم با خطاهای جزئی مواجه میشود. یک سرور ممکن است ریستارت شود، یک دیسک ممکن است پر شود، یک اتصال شبکه ممکن است قطع شود. Pipeline داده مقاوم سیستمی است که این خطاها را پیشبینی کرده و برای آنها آماده است.
یک Pipeline داده مقاوم سیستمی نیست که هرگز خطا ندهد؛ بلکه سیستمی است که در صورت بروز خطا، رفتار پیشبینیشدهای دارد، دادهای را از دست نمیدهد و بدون دخالت انسانی (یا با حداقل آن) قادر به بازیابی خود است.
🔑 نکته کلیدی: مقاومت یک ویژگی نیست که در پایان به سیستم اضافه شود؛ بلکه یک اصل طراحی است که باید از ابتدا در معماری Pipeline داده مقاوم تنیده شود.
🟠 الگوی اول: Idempotency (تکرارپذیری امن) در Pipeline داده مقاوم
بنیادیترین اصل در سیستمهای توزیعشده و Pipeline داده مقاوم، Idempotency است.
تعریف: یک عملیات Idempotent است اگر اجرای چندینباره آن، همان نتیجهای را داشته باشد که اجرای یکباره آن دارد.
در سناریوی «At-least-once delivery» (که در Kafka و اکثر سیستمهای صف رایج است)، ممکن است یک پیام دوبار پردازش شود. اگر Pipeline داده مقاوم شما Idempotent نباشد، داده تکراری ایجاد میشود که باعث خراب شدن تحلیلهای مالی و گزارشها میگردد.
| روش | توضیح | ابزار |
|---|---|---|
| 🔑 کلیدهای یکتا | استفاده از کلیدهای قطعی | UPSERT/MERGE |
| 📊 جدول Deduplication | ذخیره ID پیامهای پردازش شده | RocksDB, Kafka Streams |
| 📁 دایرکتوری موقت | نوشتن اتمیک پس از موفقیت | Spark |
# شبه کد: الگوی Upsert برای Idempotency در Pipeline داده مقاوم
def process_event(event, db_cursor):
    event_id = hash(event['timestamp'] + event['user_id'])
    query = """
    INSERT INTO events (id, data, updated_at)
    VALUES (%s, %s, NOW())
    ON CONFLICT (id) DO UPDATE
    SET data = EXCLUDED.data, updated_at = NOW();
    """
    db_cursor.execute(query, (event_id, event['payload']))
💡 نکته حرفهای: همیشه از کلیدهای Deterministic استفاده کنید تا پردازش مجدد همان پیام، همان کلید را تولید کند. برای مطالعه بیشتر درباره Idempotency در سیستمهای توزیعشده، مستندات رسمی Apache Kafka را ببینید (پیوند خارجی DoFollow).
همچنین اگر با معماری کافکا آشنایی ندارید، مقاله داخلی ما با عنوان «معماری کافکا برای مبتدیان» را مطالعه کنید.
🟡 الگوی دوم: صف نامههای مرده (Dead Letter Queue – DLQ) در Pipeline داده مقاوم
یکی از بدترین اتفاقات در Pipeline داده مقاوم، مواجهه با یک رکورد خراب (Poison Pill) است که باعث کرش کردن پردازشگر میشود. اگر سیستم مدام تلاش کند این رکورد را پردازش کند، کل پایپلاین مسدود میشود.
📊 معماری DLQ در Pipeline داده مقاوم
| جزء | نقش |
|---|---|
| 📥 Main Topic | جریان اصلی داده |
| ⚙️ Consumer | پردازش پیامها |
| 🗑️ DLQ Topic | ذخیره پیامهای مشکلدار |
| 🔍 Investigator | بررسی و رفع باگ |
راهکار: پیامهایی که پردازش آنها با شکست مواجه میشود (مثلاً فرمت JSON اشتباه است) نباید دور ریخته شوند و نباید صف را مسدود کنند. آنها باید به یک «صف جانبی» هدایت شوند. Pipeline داده مقاوم همیشه یک DLQ برای خطاهای منطقی دارد.
مزیت کلیدی: DLQ به مهندسان اجازه میدهد پیامهای خراب را بررسی کنند، باگ را رفع کنند و آنها را مجدداً به صف اصلی تزریق کنند — بدون از دست دادن داده.
برای آشنایی با الگوهای پیامرسانی در سیستمهای رویدادمحور، راهنمای معماری میکروسرویسها را ببینید (پیوند خارجی).
🟢 الگوی سوم: تلاش مجدد با عقبنشینی نمایی (Exponential Backoff with Jitter) در Pipeline داده مقاوم
همه خطاها دائمی نیستند. خطاهای گذرا مانند قطعی لحظهای شبکه یا Throttling دیتابیس بسیار رایج هستند. یک Pipeline داده مقاوم باید بین خطای گذرا و دائمی تمایز قائل شود.
⚠️ استراتژی ساده (خطرناک): تلاش مجدد بلافاصله. این کار میتواند منجر به «Thundering Herd Problem» شود.
✅ استراتژی مقاوم: استفاده از Exponential Backoff به همراه Jitter (تصادفیسازی):
| تلاش | انتظار |
|---|---|
| 1️⃣ | ۱ ثانیه |
| 2️⃣ | ۲ ثانیه |
| 3️⃣ | ۴ ثانیه |
| 4️⃣ | ۸ ثانیه |
import time
import random

def reliable_request(func, max_retries=5):
    for i in range(max_retries):
        try:
            return func()
        except TransientError:
            sleep_time = (2 ** i) + random.uniform(0, 1)
            print(f"Retrying in {sleep_time:.2f} seconds...")
            time.sleep(sleep_time)
    raise PermanentError("Max retries exceeded")
💡 نکته: Jitter از هماهنگی ناخواسته Retryها جلوگیری میکند. برای مطالعه الگوهای Retry در سیستمهای توزیعشده، مستندات AWS درباره Exponential Backoff را ببینید.
🔵 الگوی چهارم: مدار شکن (Circuit Breaker) در Pipeline داده مقاوم
این الگو از مهندسی برق و میکروسرویسها وام گرفته شده است. اگر یک سیستم مقصد کاملاً پایین است، تلاشهای مجدد فقط منابع Pipeline داده مقاوم شما را هدر میدهد.
📊 سه وضعیت مدار شکن در Pipeline داده مقاوم
| وضعیت | توضیح | رفتار |
|---|---|---|
| ✅ بسته (Closed) | همه چیز عادی است | درخواستها عبور میکنند |
| ❌ باز (Open) | خطاها از آستانه گذشته | درخواستها فوراً رد میشوند |
| 🔄 نیمه باز (Half-Open) | اجازه تست محدود | اگر موفق بود، بسته میشود |
مزیت: جلوگیری از سرریز شدن منابع در پایپلاینهای با توان عملیاتی بالا. برای جزئیات بیشتر درباره Circuit Breaker، الگوی رسمی در Microservices.io را مطالعه کنید.
مقاله داخلی ما «مدار شکن در معماری میکروسرویس» نیز میتواند کمک کند.
🟣 الگوی پنجم: فشار معکوس (Backpressure) در Pipeline داده مقاوم
در پایپلاینهای استریمینگ، اغلب سرعت تولید داده از سرعت مصرف بیشتر میشود. اگر مکانیزمی برای مدیریت این وضعیت در Pipeline داده مقاوم نباشد، بافرها پر شده و سیستم با خطای OutOfMemory کرش میکند.
📊 استراتژیهای Backpressure در Pipeline داده مقاوم
| استراتژی | توضیح | مناسب برای |
|---|---|---|
| 📥 Pull-based | مصرفکننده رئیس است | Kafka |
| ⏱️ Rate Limiting | محدودیت مصنوعی سرعت | APIها |
| 💾 Buffering | استفاده از دیسک به جای RAM | حجم بالا |
| 🗑️ Load Shedding | حذف دادههای قدیمی | سنسورهای IoT |
برای مطالعه درباره Backpressure در Apache Kafka، مستندات رسمی کافکا را ببینید.
🟤 الگوی ششم: Transactional Outbox (تضمین یکپارچگی دوگانه) در Pipeline داده مقاوم
یک چالش رایج در Pipeline داده مقاوم: شما میخواهید یک رکورد را در دیتابیس ذخیره کنید و یک پیام را در Kafka منتشر کنید. اگر دیتابیس ذخیره شود اما Kafka فیل شود چه؟
📊 راهکار Outbox در Pipeline داده مقاوم
| مرحله | اقدام |
|---|---|
| 1️⃣ | ذخیره داده + درج پیام در جدول outbox (در یک تراکنش) |
| 2️⃣ | سرویس جداگانه (Debezium) جدول را میخواند |
| 3️⃣ | پیام به Kafka ارسال میشود |
| 4️⃣ | پس از تایید، رکورد از outbox پاک میشود |
مزیت: تضمین At-least-once — هیچ رویدادی گم نمیشود. برای آشنایی با Debezium و الگوی Outbox، مستندات رسمی Debezium را مطالعه کنید.
⚫ الگوی هفتم: اعتبارسنجی اسکیما (Schema Validation & Registry) در Pipeline داده مقاوم
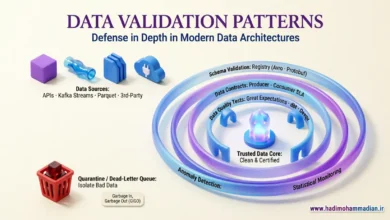
دادههای کثیف میتوانند Pipeline داده مقاوم پاییندست را آلوده کنند. تغییر فرمت یک فیلد از String به Integer میتواند باعث شکستن کل سیستم انبار داده شود.
📊 راهکار Schema Registry در Pipeline داده مقاوم
| جزء | نقش |
|---|---|
| 📋 Schema Registry | ثبت و ورژنبندی اسکیما |
| ⚡ Enforcement | جلوگیری از تغییرات ناسازگار |
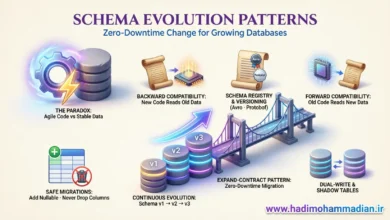
| 🔒 Contract Testing | اسکیما به عنوان قرارداد بین تیمها |
برای پیادهسازی Schema Registry، مستندات Confluent Schema Registry را ببینید.
مقاله داخلی ما با عنوان «اعتبارسنجی اسکیما با Schema Registry» نیز مفید است.
⚪ الگوی هشتم: پارتیشنبندی و ایزولاسیون (Bulkhead Pattern) در Pipeline داده مقاوم
همانطور که کشتیها دارای دیوارهای حائل هستند تا در صورت سوراخ شدن بدنه، کل کشتی غرق نشود، Pipeline داده مقاوم نیز باید ایزوله باشد.
📊 استراتژیهای ایزولاسیون در Pipeline داده مقاوم
| استراتژی | توضیح |
|---|---|
| 📥 پارتیشنبندی | مشکل در یک پارتیشن، سایرین را متاثر نمیکند |
| 🏗️ جداسازی منابع | کلاستر جداگانه برای پایپلاینهای حیاتی |
⚠️ هشدار: نباید پردازش یک گزارش سنگین ماهانه باعث تاخیر در داشبورد زنده مدیرعامل شود.
برای مطالعه بیشتر درباره Bulkhead Pattern، الگوی Bulkhead در Microsoft Docs را ببینید.
✅ بخش ۱۰: نتیجهگیری – تست و نظارت (Observability) در Pipeline داده مقاوم
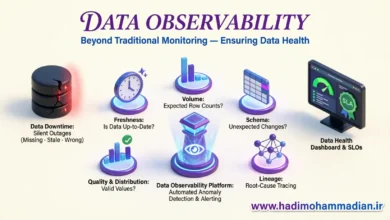
هیچ یک از الگوهای بالا بدون نظارت دقیق کامل نیستند. برای داشتن یک Pipeline داده مقاوم، باید روی «مشاهدهپذیری» سرمایهگذاری کنید:
| نوع نظارت | ابزار | تمرکز |
|---|---|---|
| 🔍 Tracing | OpenTelemetry | ردیابی داده از ورود تا ذخیره |
| 📊 Metrics | Prometheus | Lag، Error Rate، Throughput |
| 🚨 Alerting | Grafana | هشدارهای هوشمند |
📋 چکلیست مقاومت Pipeline داده مقاوم
✅ آیا عملیات نوشتن شما Idempotent است؟
✅ آیا برای خطاهای منطقی صف DLQ دارید؟
✅ آیا برای خطاهای شبکه از Exponential Backoff استفاده میکنید؟
✅ آیا مانیتورینگ شما مقدار Consumer Lag را نشان میدهد؟
✅ آیا تغییرات اسکیما به صورت خودکار اعتبارسنجی میشوند؟
✅ آیا سیستم در برابر افزایش ناگهانی بار محافظت شده است؟
💡 پیام نهایی: ساخت Pipeline داده مقاوم به معنی پیشبینی شکستهاست. با ترکیب Idempotency، Retry/Backoff، DLQ و Circuit Breaker، شما سیستمی میسازید که نه تنها در برابر طوفان دادهها خم نمیشود، بلکه اعتماد کسبوکار به دادهها را تضمین میکند.