
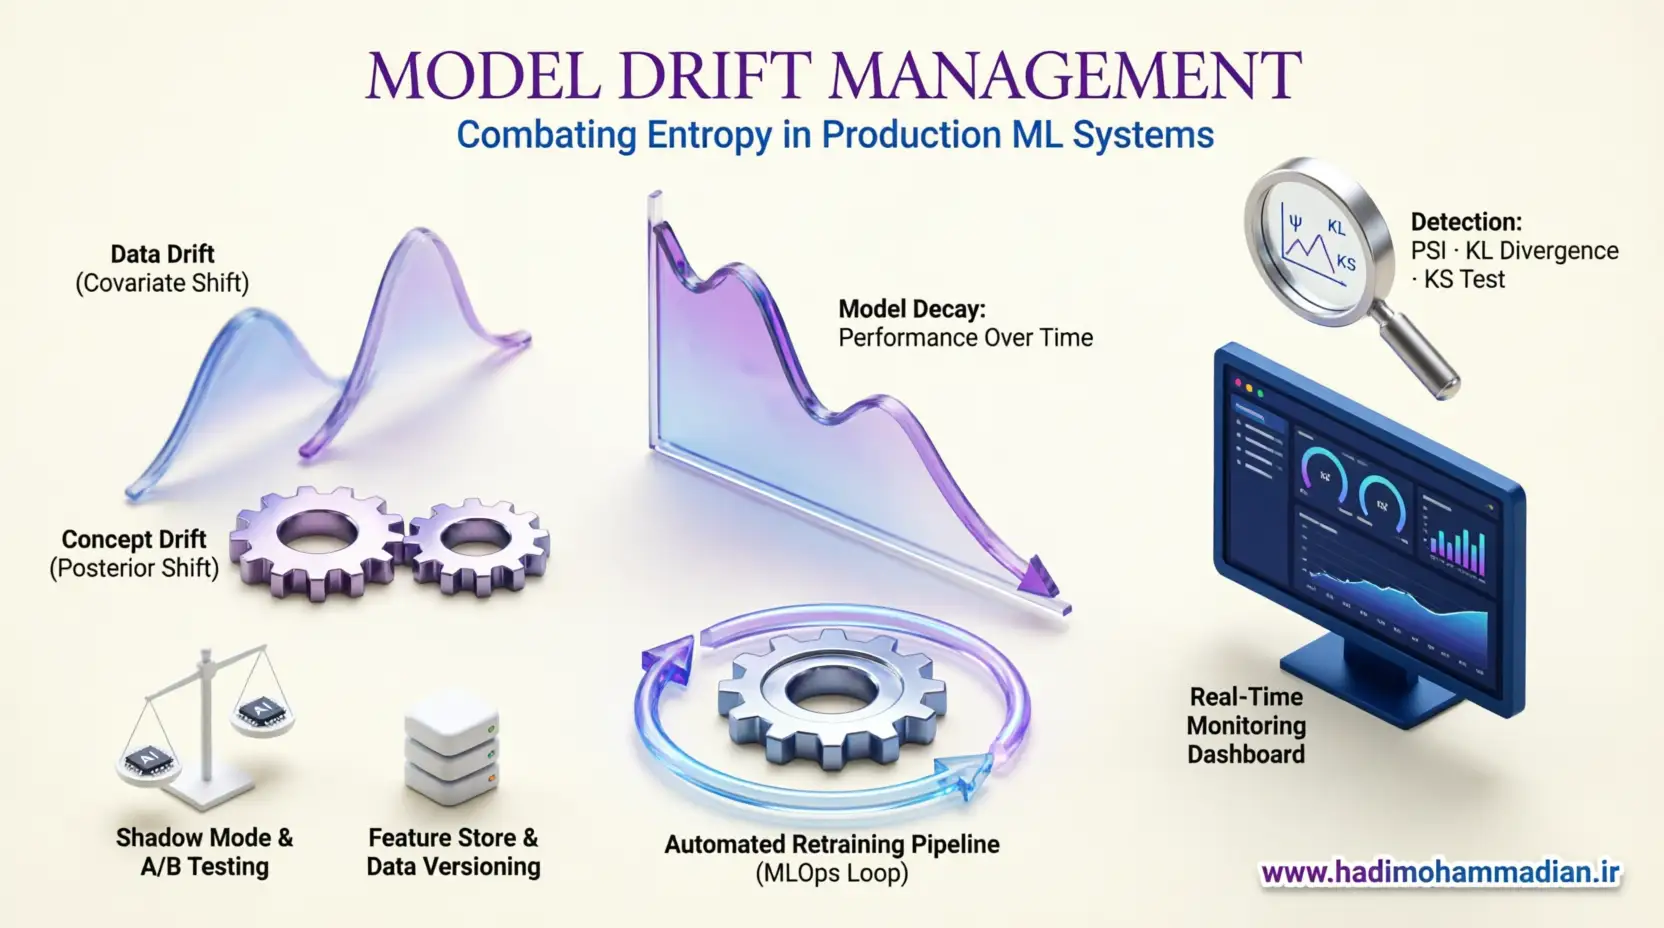
استراتژیهای مدیریت رانش مدل (Model Drift) در محیطهای عملیاتی
برخلاف نرمافزارهای سنتی که منطق آنها ثابت است (Deterministic)، مدلهای یادگیری ماشین موجوداتی زنده و وابسته به داده هستند. قانون نانوشتهای در MLOps وجود دارد: «عملکرد مدل به محض استقرار در محیط عملیاتی، شروع به تنزل میکند.» مدیریت رانش مدل دقیقاً به همین چالش پاسخ میدهد. این قانون مانند قانون دوم ترمودینامیک در فیزیک است — آنتروپی همیشه در حال افزایش است و سیستمها به سمت بینظمی حرکت میکنند.
این پدیده که به عنوان فرسایش مدل (Model Decay) یا رانش (Drift) شناخته میشود، ناشی از تغییرات پویای جهان واقعی است. دادههایی که مدل با آنها آموزش دیده، تنها یک عکس فوری از واقعیت در یک بازه زمانی خاص بودهاند. وقتی واقعیت تغییر میکند اما مدل ثابت میماند، تصمیمات مدل به تدریج بیارزش و حتی خطرناک میشوند. مدیریت رانش مدل هنر تشخیص به موقع این تغییرات و واکنش هوشمندانه به آنهاست.
این نوشتار به بررسی عمیق انواع رانش، ریاضیات تشخیص آن، معماریهای نظارتی و استراتژیهای اصلاحی در مدیریت رانش مدل میپردازد.
🔑 نکته کلیدی: مدلهای یادگیری ماشین مانند موجودات زنده هستند — آنها یا در حال تطبیق با محیط هستند یا در حال مرگ. مدیریت رانش مدل، هنر تشخیص به موقع تغییرات و واکنش هوشمندانه به آنهاست.
🟠 فصل اول: تاکسونومی رانش در مدیریت رانش مدل (Drift Taxonomy)
برای مبارزه با دشمن، ابتدا باید آن را شناخت. در ادبیات آکادمیک و صنعتی، رانش به سه دسته اصلی تقسیم میشود که تشخیص و درمان هر کدام متفاوت است. درک تفاوت بین این انواع، اولین گام برای طراحی استراتژی مناسب مدیریت رانش مدل است.
📊 ۱.۱. رانش داده (Data Drift / Covariate Shift) در مدیریت رانش مدل
تغییر در توزیع دادههای ورودی P(X).
تعریف: مدل همان رابطه قبلی را میداند، اما دادههایی که دریافت میکند تغییر کردهاند. این رایجترین نوع رانش است و معمولاً زودتر از سایر انواع قابل تشخیص است.
مثال: یک مدل تشخیص اشیاء که با تصاویر روز آموزش دیده است، ناگهان در محیط شب به کار گرفته میشود. یا در یک مدل امتیازدهی اعتباری، میانگین درآمد متقاضیان وام به دلیل تورم افزایش مییابد.
فرمول: P_train(Y|X) = P_serve(Y|X) اما P_train(X) ≠ P_serve(X)
🔄 ۱.۲. رانش مفهوم (Concept Drift / Posterior Probability Shift) در مدیریت رانش مدل
تغییر در رابطه بین ورودی و خروجی P(Y|X).
تعریف: دادههای ورودی ثابت ماندهاند، اما معنای آنها تغییر کرده است. این خطرناکترین نوع رانش است زیرا تشخیص آن دشوارتر است.
مثال: قبل از کرونا، خرید حجم زیادی دستمال کاغذی رفتار عادی بود. در دوران کرونا، این رفتار نشانگر احتکار یا ترس بود. الگوی ورودی تغییر نکرده، اما برچسب از «عادی» به «غیرعادی» تغییر کرده است.
فرمول: P_train(X) = P_serve(X) اما P_train(Y|X) ≠ P_serve(Y|X)
🏷️ ۱.۳. رانش برچسب (Label Drift / Prior Probability Shift) در مدیریت رانش مدل
تغییر در توزیع خروجی یا هدف P(Y).
تعریف: نسبت کلاسهای هدف در محیط واقعی تغییر میکند.
مثال: در یک سیستم تشخیص هرزنامه، ناگهان یک حمله سایبری رخ میدهد و نسبت ایمیلهای اسپم از ۱۰٪ به ۹۰٪ میرسد.
📊 جدول انواع رانش در مدیریت رانش مدل
| نوع رانش | تغییر | فرمول | خطرناکی |
|---|---|---|---|
| 📊 Data Drift | P(X) | P_train(X) ≠ P_serve(X) | متوسط |
| 🔄 Concept Drift | P(Y|X) | P_train(Y|X) ≠ P_serve(Y|X) | ⭐ بالا |
| 🏷️ Label Drift | P(Y) | P_train(Y) ≠ P_serve(Y) | متوسط |
برای آشنایی بیشتر با مفهوم Covariate Shift، مقاله ویکیپدیا درباره Covariate Shift را مطالعه کنید.
🟡 فصل دوم: زرادخانه تشخیص در مدیریت رانش مدل (Detection Arsenal)
چگونه متوجه شویم که مدل دچار رانش شده است؟ ما نمیتوانیم همیشه منتظر بمانیم تا برچسبهای واقعی (Ground Truth) برسند. بنابراین باید از پروکسیهای آماری در مدیریت رانش مدل استفاده کنیم.
📊 ۲.۱. روشهای آماری تکمتغیره (Univariate Statistical Tests) در مدیریت رانش مدل
این روشها توزیع یک ویژگی خاص در زمان آموزش را با زمان حال مقایسه میکنند.
الف) آزمون کولموگروف-اسمیرنوف (Kolmogorov-Smirnov / KS Test)
| جنبه | توضیح |
|---|---|
| 🔧 کاربرد | ویژگیهای عددی پیوسته |
| ⚙️ مکانیسم | حداکثر فاصله عمودی بین CDF دو دیتاست |
| ✅ مزیت | حساس به تغییرات شکل توزیع |
| ⚠️ نقطه ضعف | نامناسب برای دادههای با ابعاد بالا |
ب) شاخص پایداری جمعیت (Population Stability Index – PSI)
| جنبه | توضیح |
|---|---|
| 🔧 کاربرد | استاندارد طلایی در صنعت مالی |
| ⚙️ مکانیسم | تقسیم به باکتها و سنجش تفاوت درصد |
تفسیر PSI در مدیریت رانش مدل:
| مقدار | تفسیر | اقدام |
|---|---|---|
| 🟢 PSI < 0.1 | تغییر ناچیز | ادامه نظارت |
| 🟡 0.1 < PSI < 0.25 | تغییر جزئی | بررسی بیشتر |
| 🔴 PSI > 0.25 | تغییر عمده | مدل نامعتبر است |
ج) واگرایی کولبک-لایبلر (KL Divergence) و Jensen-Shannon
کاربرد: سنجش میزان اطلاعات از دست رفته وقتی یک توزیع برای تقریب توزیع دیگر استفاده میشود. مناسب برای دادههای دستهای و پیوسته.
📈 ۲.۲. روشهای نظارت بر عملکرد (Performance Monitoring) در مدیریت رانش مدل
اگر فیدبک سریع دارید (مثلاً در سیستمهای پیشنهاد دهنده)، بهترین روش نظارت مستقیم بر متریکهاست.
| متریک | کاربرد |
|---|---|
| 📊 Accuracy | صحت کلی |
| 🎯 F1-Score | تعادل Precision و Recall |
| 📈 ROC-AUC | کیفیت تفکیک کلاسها |
| ⚖️ Precision/Recall | بسته به نیاز |
⚠️ هشدار: افت ناگهانی در این متریکها نشانه قطعی Concept Drift است.
🧠 ۲.۳. روشهای تشخیص چندمتغیره (Multivariate Drift Detection) در مدیریت رانش مدل
گاهی تکتک ویژگیها تغییر نکردهاند، اما همبستگی بین آنها تغییر کرده است.
| روش | توضیح |
|---|---|
| 📉 PCA/Autoencoders | خطای بازسازی را اندازه بگیرید |
| 🎯 Domain Classifier | مدلی که سعی کند تشخیص دهد داده از کدام دیتاست است |
Domain Classifier: یک مدل ساده بسازید که سعی کند تشخیص دهد آیا یک رکورد داده متعلق به دیتاست آموزش است یا دیتاست جدید. اگر این مدل بتواند با دقت بالا این دو را تفکیک کند، یعنی رانش شدیدی رخ داده است.
برای مطالعه بیشتر درباره PSI، مستندات Evidently AI درباره PSI را ببینید.
مقاله داخلی ما با عنوان «نظارت بر مدلهای یادگیری ماشین در تولید» نیز میتواند کمک کند.
🟢 فصل سوم: استراتژیهای اصلاح و پاسخ در مدیریت رانش مدل (Remediation Strategies)
پس از تشخیص رانش، سیستم یا انسان باید مداخله کند. استراتژی انتخابی در مدیریت رانش مدل به هزینه بازآموزی و سرعت تغییرات بستگی دارد.
🔄 ۳.۱. بازآموزی کامل (Full Retraining) در مدیریت رانش مدل
روش: مدل فعلی دور ریخته میشود و یک مدل جدید روی ترکیبی از دادههای قدیمی و جدید آموزش میبیند.
زمان استفاده: وقتی Data Drift شدید است اما Concept Drift رخ نداده، یا وقتی تغییرات فصلی است.
📈 ۳.۲. یادگیری افزایشی (Incremental / Online Learning) در مدیریت رانش مدل
روش: وزنهای مدل قبلی حفظ میشوند و مدل فقط با دادههای جدید بهروزرسانی میشود.
زمان استفاده: برای مدلهای شبکههای عصبی یا الگوریتمهایی که از partial_fit پشتیبانی میکنند.
⚠️ ریسک: فراموشی فاجعهبار (Catastrophic Forgetting). ممکن است مدل دانش قبلی خود را از دست بدهد.
⚖️ ۳.۳. وزندهی به نمونهها (Instance Weighting) در مدیریت رانش مدل
روش: به جای حذف دادههای قدیمی، وزن آنها را در تابع هزینه کاهش میدهیم و به دادههای اخیر وزن بیشتری میدهیم.
زمان استفاده: وقتی تغییرات تدریجی (Gradual Drift) است.
🎯 ۳.۴. روش گروهی (Ensemble Methods for Drift) در مدیریت رانش مدل
| روش | توضیح |
|---|---|
| ⚖️ Weighted Ensemble | ترکیب مدلهای آموزش دیده روی بازههای زمانی مختلف |
| 🎯 Dynamic Selection | انتخاب مدل مناسب برای هر نمونه ورودی |
📊 جدول استراتژیهای اصلاح در مدیریت رانش مدل
| استراتژی | سرعت تطبیق | ریسک | مناسب برای |
|---|---|---|---|
| 🔄 Full Retraining | کند | کم | Drift فصلی |
| 📈 Online Learning | سریع | متوسط | Streaming |
| ⚖️ Instance Weighting | متوسط | کم | تغییر تدریجی |
| 🎯 Ensemble | سریع | کم | محیط ناپایدار |
🔵 فصل چهارم: معماری مرجع سیستم نظارت در مدیریت رانش مدل (Reference Architecture)
یک سیستم مدیریت رانش مدل در سطح سازمانی باید شامل اجزای زیر باشد:
🏗️ اجزای معماری مدیریت رانش مدل
| لایه | نقش | ابزار |
|---|---|---|
| ⚡ Inference Layer | سرویسدهنده مدل + لاگبرداری | TensorFlow Serving, Seldon |
| 📊 Feature Store | دسترسی به آمار زمان آموزش | Feast, Tecton |
| 📈 Evaluation Engine | اجرای تستهای آماری | Evidently AI, Arize |
| 💾 Metadata Store | ذخیره نتایج و Lineage | MLflow |
| 🔄 Retraining Pipeline | فرآیند ساخت مدل جدید | Airflow, Kubeflow |
📊 متریکهای نظارتی حیاتی در مدیریت رانش مدل
| متریک | توضیح | هشدار |
|---|---|---|
| 📊 PSI | شاخص پایداری جمعیت | > 0.25 |
| 📈 KS Statistic | فاصله توزیعها | P-value < 0.05 |
| 🎯 Accuracy | صحت مدل | افت ناگهانی |
| ⚡ Latency | تأخیر پاسخ | افزایش ناگهانی |
برای آشنایی با Evidently AI، مستندات رسمی Evidently را مطالعه کنید.
🟣 فصل پنجم: مطالعه موردی گامبهگام مدیریت رانش مدل (سیستم امتیازدهی اعتباری بانک)
بیایید یک سناریوی واقعی از مدیریت رانش مدل را شبیهسازی کنیم. فرض کنید شما معمار MLOps یک بانک هستید. مدل Credit_Scoring_v1 در حال اجراست.
🎯 گام ۱: ایجاد خط مبنا (Baseline Establishment)
قبل از استقرار، ما آمار توصیفی دیتاست آموزش را استخراج کرده و در قالب یک فایل reference_schema.json ذخیره میکنیم.
مثال: میانگین سنی متقاضیان: ۳۵ سال، انحراف معیار: ۱۰. توزیع درآمد: نرمال با کشیدگی جزئی.
🎯 گام ۲: پیکربندی پنجرههای نظارتی (Monitoring Windows) در مدیریت رانش مدل
| پنجره | تنظیم | دلیل |
|---|---|---|
| ⚡ تشخیص | روزانه (Daily Batch) | کاهش نوسانات |
| 📊 مرجع | ۳۰ روز گذشته | Moving Window |
| 🎯 ثابت | دیتاست آموزش اولیه | Fixed Reference |
🎯 گام ۳: سناریوی رانش (The Drift Event)
رخداد: دولت سیاستهای اقتصادی جدیدی اعمال میکند که باعث افزایش ناگهانی وامهای خرد میشود.
مشاهده: در روز دوشنبه، سیستم مانیتورینگ هشداری ارسال میکند:
Alert: Feature 'debt_to_income_ratio' PSI = 0.35 (Critical Drift)
🎯 گام ۴: تحلیل ریشه (Root Cause Analysis – RCA) در مدیریت رانش مدل
| بررسی | نتیجه |
|---|---|
| 📊 Data Drift | ✅ توزیع debt_to_income به سمت راست جابجا شده |
| 🔄 Concept Drift | ❓ نتیجه وامها ماهها طول میکشد |
| 🎯 Ground Truth | ❌ در دسترس نیست |
راهکار: استفاده از پروکسیهای زودرس (Early Proxies). مثلاً «تأخیر در اولین قسط».
🎯 گام ۵: استراتژی اصلاح (Remediation) در مدیریت رانش مدل
| اقدام | توضیح |
|---|---|
| 🛡️ اقدام فوری | حالت محافظهکارانه (Conservative Fallback) |
| 👤 Human Review | ارجاع موارد مشکوک به بررسی انسانی |
| 🔄 بازآموزی | جمعآوری دادههای ۲ ماه اخیر |
| 🧪 تست A/B | مدل v2 روی ۱۰٪ ترافیک (Canary) |
| ✅ تایید | مقایسه نرخ «تأخیر اولین قسط» |
🟤 فصل ششم: کدنویسی و پیادهسازی مدیریت رانش مدل (Python Example)
در این بخش یک مثال ساده با استفاده از کتابخانه scikit-learn و scipy برای تشخیص رانش با روش KS-Test را میبینیم.
import numpy as np import pandas as pd from scipy.stats import ks_2samp from sklearn.ensemble import RandomForestClassifier # 1. شبیهسازی دادههای آموزش (گذشته) np.random.seed(42) train_data = np.random.normal(loc=50, scale=10, size=1000) # میانگین 50 # 2. شبیهسازی دادههای تولید (حال - با رانش) prod_data = np.random.normal(loc=55, scale=10, size=1000) # میانگین 55 # 3. تابع تشخیص رانش def detect_drift(reference, current, threshold=0.05): """اجرای آزمون KS برای تشخیص تغییر توزیع""" statistic, p_value = ks_2samp(reference, current) print(f"KS Statistic: {statistic:.4f}, P-Value: {p_value:.4e}") if p_value < threshold: return True, "DRIFT DETECTED: توزیعها به طور معناداری متفاوت هستند." else: return False, "NO DRIFT: توزیعها مشابه هستند." # 4. اجرا is_drift, message = detect_drift(train_data, prod_data) print(message) # 5. شبیهسازی یک سیستم آلارم ساده class ModelMonitor: def __init__(self, reference_data): self.reference_data = reference_data self.daily_batch = [] def add_prediction_log(self, feature_value): self.daily_batch.append(feature_value) def check_health(self): if not self.daily_batch: return drift_detected, msg = detect_drift(self.reference_data, self.daily_batch) if drift_detected: self.trigger_retraining() else: print("سیستم سالم است.") self.daily_batch = [] def trigger_retraining(self): print(">>> هشدار: پایپلاین بازآموزی در Airflow فراخوانی شد...") # استفاده از کلاس مانیتور monitor = ModelMonitor(train_data) for val in prod_data[:100]: monitor.add_prediction_log(val) monitor.check_health()
⚫ فصل هفتم: نکات پیشرفته و چالشها در مدیریت رانش مدل
🔄 ۷.۱. حلقه بازخورد (The Feedback Loop Problem) در مدیریت رانش مدل
در بسیاری از سیستمها (مثل توصیهگرها)، تصمیم مدل روی دادههای آینده تأثیر میگذارد. اگر مدل شما فقط فیلمهای اکشن پیشنهاد دهد، کاربر فقط روی فیلمهای اکشن کلیک میکند. دادههای آموزشی بعدی پر از فیلم اکشن میشود و مدل دچار بایاس خود-تقویتکننده میشود.
راه حل: استفاده از Exploration vs Exploitation. همیشه درصدی از ترافیک را به پیشنهادات تصادفی اختصاص دهید.
🎯 ۷.۲. تمایز بین رانش و داده پرت (Outliers vs Drift) در مدیریت رانش مدل
یک نوسان ناگهانی در دادهها (مثلاً Black Friday) لزوماً Drift نیست، بلکه یک Outlier یا Seasonality است. سیستم مدیریت رانش مدل باید هوشمند باشد تا به خاطر یک روز خاص، مدل را از کار نیندازد.
راهکار: استفاده از میانگینهای متحرک (Moving Averages) به جای مقادیر لحظهای.
👤 ۷.۳. نقش انسان در حلقه (Human-in-the-loop) در مدیریت رانش مدل
اتوماسیون کامل بازآموزی خطرناک است. ممکن است دادههای جدید «فاسد» باشند.
بهترین تمرین: فرآیند تشخیص رانش و آمادهسازی مدل کاندید خودکار باشد، اما دکمه نهایی استقرار توسط یک انسان فشرده شود.
📊 جدول چالشها و راهکارها در مدیریت رانش مدل
| چالش | راهکار |
|---|---|
| 🔄 حلقه بازخورد | Exploration vs Exploitation |
| 🎯 Outlier vs Drift | Moving Averages |
| 👤 خطر اتوماسیون کامل | Human-in-the-loop |
| ⚡ تأخیر Ground Truth | Early Proxies |
مقاله داخلی ما با عنوان «Human-in-the-loop در سیستمهای هوش مصنوعی» را مطالعه کنید.
✅ نتیجهگیری: چکلیست نهایی مدیریت رانش مدل
مدیریت رانش مدل یک «ویژگی اضافی» نیست، بلکه بخش جداییناپذیر چرخه حیات یادگیری ماشین است. بدون استراتژی تشخیص و اصلاح، هوشمندترین مدلها نیز به مرور زمان به مولدهای اعداد تصادفی (و گاهاً مضر) تبدیل میشوند.
📌 نکات کلیدی موفقیت در مدیریت رانش مدل
| اصل | توضیح |
|---|---|
| 📊 تشخیص زودهنگام | KS Test + PSI |
| 🎯 نظارت مداوم | Daily Batch + Moving Window |
| 🔄 استراتژی اصلاح | Full Retraining + Online Learning |
| 👤 Human-in-the-loop | تایید نهایی توسط انسان |
💡 پیام نهایی: سازمانهای موفق آنهایی نیستند که بهترین مدل را در روز اول میسازند، بلکه آنهایی هستند که بهترین زیرساخت تکاملی را برای انطباق مدل با تغییرات جهان بنا میکنند. مدیریت رانش مدل به شما کمک میکند معماری خود را بر اساس تغییر بنا کنید، نه ثبات.


