
الگوهای Feature Store برای سیستمهای یادگیری ماشین سازمانی
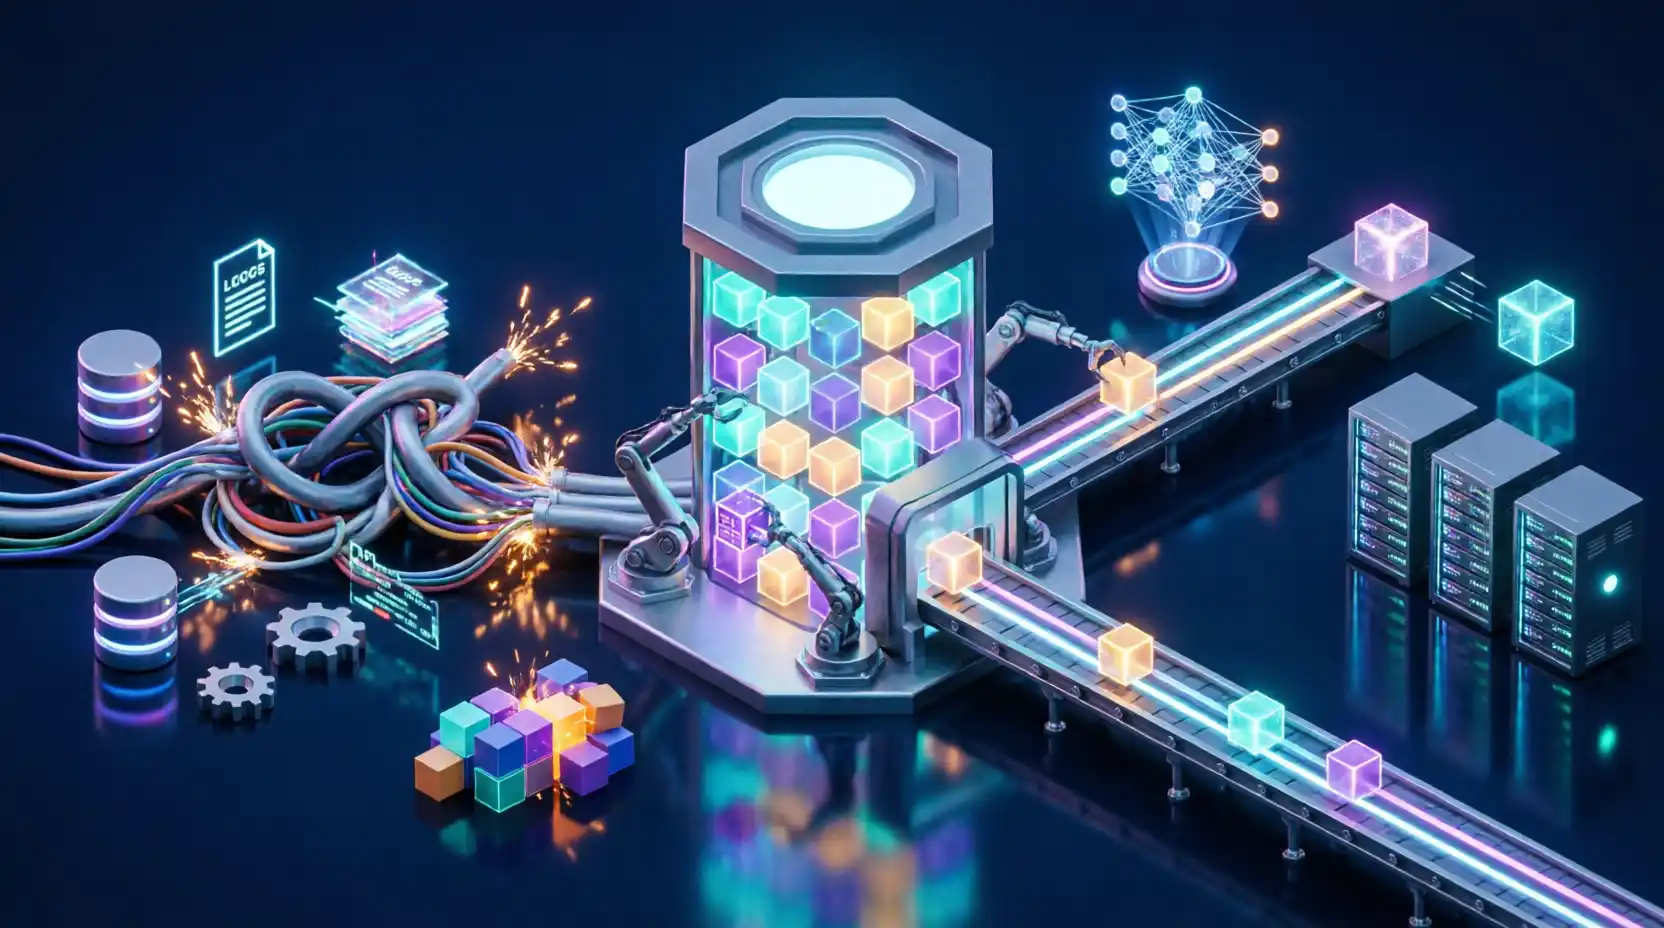
در عصر حاضر، سازمانها از مرحله «اثبات مفهوم» (PoC) در هوش مصنوعی عبور کرده و به سمت عملیاتیسازی مدلها در مقیاس بالا حرکت کردهاند. این گذار از آزمایشگاه به تولید، چالشهای جدیدی را آشکار کرده است که در مرحله PoC پنهان بودند. الگوهای Feature Store به عنوان راهحلی برای مدیریت بحران داده در یادگیری ماشین ظهور کردهاند. اما با افزایش تعداد مدلها، یک گلوگاه خطرناک نمایان میشود: هرجومرج در خطوط لوله داده (Data Pipeline Chaos).
در یک محیط سنتی بدون الگوهای Feature Store، دانشمندان داده برای هر مدل، کدهای SQL یا Python مجزایی مینویسند تا دادههای خام را استخراج و پردازش کنند. این رویکرد منجر به ایجاد سیلوهای داده، کدهای اسپاگتی، عدم تطابق منطق در آموزش و استنتاج (Training-Serving Skew) و ناتوانی در استفاده مجدد از ویژگیها میشود.
Feature Store به عنوان لایه رابط داده (Data Interface Layer) بین دادههای خام و مدلهای یادگیری ماشین ظهور کرده است تا این چالشها را با الگوهای Feature Store دقیق حل کند. این نوشتار به تشریح عمیق الگوهای معماری، استراتژیهای پیادهسازی و یک مطالعه موردی گامبهگام میپردازد.
🔑 نکته کلیدی: الگوهای Feature Store پلی هستند بین دنیای داده (Data Engineering) و دنیای مدل (Data Science). این پل تضمین میکند که مدلها دقیقاً همان دادههایی را در تولید میبینند که در آموزش دیدهاند.
🟠 فصل اول: کالبدشکافی معماری الگوهای Feature Store سازمانی
یک Feature Store مدرن صرفاً یک پایگاه داده نیست؛ بلکه یک پلتفرم ارکستراسیون (Orchestration Platform) برای چرخه حیات ویژگیهاست. معماری الگوهای Feature Store بر اساس اصل جداسازی محاسبات از ذخیرهسازی و جداسازی منطق از زیرساخت بنا شده است.
💾 ۱.۱. الگوی ذخیرهسازی دوگانه (The Hybrid Storage Pattern) در الگوهای Feature Store
قلب تپنده الگوهای Feature Store، الگوی ذخیرهسازی دوگانه است که تضاد ذاتی بین نیازهای «آموزش مدل» و «سرویسدهی مدل» را حل میکند. این دو نیاز به قدری متفاوت هستند که هیچ پایگاه داده واحدی نمیتواند هر دو را به خوبی برآورده کند.
الف) مخزن آفلاین (Offline Store / Historical Store)
هدف: ارائه دادههای با حجم بالا (High Throughput) برای آموزش مدل و تحلیلهای دستهای.
| جنبه | توضیح |
|---|---|
| 📊 الزامات | پتابایتها داده تاریخی، هزینه پایین، کوئریهای سنگین |
| 💾 فناوریها | Apache Iceberg, Delta Lake, BigQuery, Snowflake, Redshift |
| 📈 الگوی دسترسی | ستونی (Columnar) و دستهای |
| ⚡ اولویت | پهنای باند و صحت تاریخی، نه تأخیر |
ب) مخزن آنلاین (Online Store / Serving Store)
هدف: ارائه بردار ویژگی (Feature Vector) به مدل در زمان واقعی با تأخیر میلیثانیهای.
| جنبه | توضیح |
|---|---|
| ⚡ الزامات | تأخیر بسیار پایین، همزمانی بالا، پایداری بالا |
| 💾 فناوریها | Redis, DynamoDB, Cassandra, Aerospike |
| 🔑 الگوی دسترسی | بر اساس کلید موجودیت (Entity ID) |
| 🎯 اولویت | سرعت بازیابی آخرین مقدار |
🔄 ۱.۲. موتور همگامسازی (Materialization Engine) در الگوهای Feature Store
چگونه دادهها بین این دو مخزن هماهنگ میشوند؟ این وظیفه موتور Materialization است. این موتور میتواند بر اساس زمانبندی (Scheduled Jobs) یا رویداد (Event-driven) عمل کند تا مقادیر جدید ویژگیها را محاسبه و در Online Store بهروزرسانی کند.
📊 جدول مقایسه Offline و Online Store در الگوهای Feature Store
| جنبه | OFFLINE STORE | ONLINE STORE |
|---|---|---|
| 📊 حجم | پتابایت | گیگابایت |
| ⚡ تأخیر | ثانیه تا ساعت | میلیثانیه |
| 💰 هزینه | پایین | بالا (RAM) |
| 🎯 کاربرد | آموزش مدل | استنتاج بلادرنگ |
برای آشنایی بیشتر با معماری Feature Store، مستندات رسمی Feast را مطالعه کنید.
🟡 فصل دوم: الگوهای پیشرفته مهندسی ویژگی در الگوهای Feature Store
در سطح سازمانی، ویژگیها یکسان خلق نمیشوند. ما با سه پارادایم اصلی روبرو هستیم که الگوهای Feature Store باید به صورت یکپارچه از آنها پشتیبانی کنند.
📦 ۲.۱. الگوی ویژگیهای دستهای (Batch Feature Pattern) در الگوهای Feature Store
این سادهترین نوع ویژگی است اما حجم عمدهای از ویژگیهای سازمانی را تشکیل میدهد.
سناریو: محاسبه «میانگین موجودی حساب در ۳ ماه گذشته».
جریان داده:
| مرحله | اقدام |
|---|---|
| 1️⃣ | ETL Job شبانه روی Data Warehouse |
| 2️⃣ | ذخیره در Offline Store |
| 3️⃣ | انتقال به Online Store |
چالش: تازگی داده (Data Freshness). این ویژگیها معمولاً تاخیر ۲۴ ساعته یا چند ساعته دارند.
⚡ ۲.۲. الگوی ویژگیهای جریانی (Streaming Feature Pattern) در الگوهای Feature Store
برای سیستمهای حساس به زمان (مانند تشخیص تقلب)، دادههای دیروز بیفایدهاند.
سناریو: «تعداد تراکنشهای ناموفق در ۱۰ دقیقه اخیر».
معماری (Kappa Architecture):
| مسیر | اقدام | تأخیر |
|---|---|---|
| 🔥 Hot Path | نتایج مستقیماً به Online Store | زیر ثانیه |
| ❄️ Cold Path | آرشیو در Offline Store | ساعتی/روزانه |
🎯 ۲.۳. الگوی ویژگیهای در لحظه (On-Demand / Request-Time Pattern) در الگوهای Feature Store
برخی ویژگیها نه قابل پیشمحاسبه هستند و نه در جریان داده وجود دارند.
سناریو: «نسبت مبلغ تراکنش جاری به میانگین موجودی». در اینجا «مبلغ تراکنش جاری» فقط در لحظه درخواست کاربر مشخص میشود.
معماری (Transformations on the fly):
| مرحله | اقدام |
|---|---|
| 1️⃣ | برنامه دادههای زمینه را میفرستد |
| 2️⃣ | Feature Store دادههای پیشمحاسبه را میخواند |
| 3️⃣ | تابع سبک در حافظه اجرا میشود |
| 4️⃣ | نتیجه به مدل تحویل میشود |
مقاله داخلی ما با عنوان «مهندسی ویژگی برای یادگیری ماشین» را مطالعه کنید.
🟢 فصل سوم: حل چالشهای حیاتی با الگوهای Feature Store
🕰️ ۳.۱. سفر در زمان و صحت نقطه در زمان (Point-in-Time Correctness) در الگوهای Feature Store
بزرگترین عامل شکست مدلهای ML، نشت داده (Data Leakage) است. اگر امروز مدلی را برای پیشبینی ریزش مشتری آموزش میدهید و از دادههای آموزشی مربوط به ۶ ماه پیش استفاده میکنید، ویژگی «تعداد تماس با پشتیبانی» باید دقیقاً مقداری باشد که مشتری در آن تاریخ داشته است، نه مقدار امروز.
الگوی طراحی: الگوهای Feature Store باید تمام تغییرات ویژگیها را با برچسب زمانی (Timestamp) ذخیره کنند.
مکانیزم Join:
| عنصر | مقدار |
|---|---|
| 🎯 Training Label | Customer A, Churned=Yes, Event_Time=2023-06-01 10:00:00 |
| 📊 سیستم | آخرین مقدار ویژگی با Timestamp <= 2023-06-01 10:00:00 |
| ✅ نتیجه | جلوگیری خودکار از Data Leakage |
🔄 ۳.۲. ثبات آموزش-سرویس (Training-Serving Consistency) در الگوهای Feature Store
مشکل: دانشمند داده ویژگی را با Python/Pandas تعریف میکند. مهندس نرمافزار همان منطق را با Java یا Go بازنویسی میکند. تفاوتهای جزئی باعث افت شدید عملکرد مدل میشود.
راه حل (Feature Definition as Code): تعریف ویژگی به یک شیء درجه اول تبدیل میشود. منطق محاسبه در یک مخزن مرکزی (Registry) ثبت میشود و همان کد واحد برای تولید دادههای Batch و Real-time استفاده میشود.
📥 ۳.۳. پر کردن خودکار دادههای تاریخی (Backfilling) در الگوهای Feature Store
وقتی یک ایده جدید برای ویژگی جریانی دارید، نمیتوانید هفتهها صبر کنید تا داده جمع شود.
الگوی طراحی: سیستم باید بتواند منطق پردازش جریانی را برداشته و روی دادههای خام تاریخی در Data Lake اجرا کند تا تاریخچه ویژگی را برای گذشته تولید کند. این یعنی یکپارچگی کامل بین Stream Processing و Batch Processing.
برای مطالعه بیشتر درباره Point-in-Time Correctness، مستندات Feast درباره Time Travel را ببینید.
🔵 فصل چهارم: سناریوی پیادهسازی گامبهگام الگوهای Feature Store
📋 سناریو: سیستم کشف تقلب بانکی
| جنبه | توضیح |
|---|---|
| 🏦 حوزه | بانکداری |
| 🎯 هدف | تشخیص تراکنشهای متقلبانه |
| ⚡ نیاز | استنتاج بلادرنگ زیر ۵۰ میلیثانیه |
| 📊 داده | تراکنشهای تاریخی + استریم زنده |
🎯 گام ۱: مدلسازی دامنه و تعریف موجودیتها
# تعریف موجودیتها در فایل پیکربندی (مثلاً با Feast) user_entity = Entity( name="user_id", value_type=ValueType.STRING, description="شناسه منحصر به فرد مشتری بانک" ) merchant_entity = Entity( name="merchant_id", value_type=ValueType.STRING, description="شناسه پذیرنده تراکنش" )
🎯 گام ۲: تعریف منابع داده (Data Sources)
# منبع داده دستهای batch_source = FileSource( path="s3://bank-data-lake/transactions", event_timestamp_column="transaction_timestamp", created_timestamp_column="created_at", ) # منبع داده جریانی stream_source = KafkaSource( name="transaction_stream", topic="transactions_topic", bootstrap_servers="kafka-broker:9092", message_format=JsonFormat( schema_json="transaction_schema.json" ), event_timestamp_column="transaction_timestamp", )
🎯 گام ۳: تعریف نماهای ویژگی (Feature Views)
ویژگی ۱: نرخ تراکنشهای کاربر (Streaming Feature)
user_transaction_stats_view = FeatureView(
    name="user_transaction_stats",
    entities=["user_id"],
    ttl=timedelta(days=1),
    schema=[
        Field(name="transaction_count_10m", dtype=Int64),
        Field(name="total_amount_10m", dtype=Float32),
    ],
    online=True,
    source=stream_source,
)
ویژگی ۲: میانگین اعتبار پذیرنده (Batch Feature)
merchant_credit_view = FeatureView(
    name="merchant_credit_score",
    entities=["merchant_id"],
    ttl=timedelta(days=30),
    online=True,
    batch_source=batch_source,
)
🎯 گام ۴: ایجاد دیتاست آموزشی (Time Travel)
# لیست تراکنشهای برچسبدار fraud_labels = pd.read_csv("historical_fraud_labels.csv") # درخواست داده آموزشی از Feature Store training_df = fs.get_historical_features( entity_df=fraud_labels, features=[ "user_transaction_stats:transaction_count_10m", "merchant_credit_score:credit_rating" ] ).to_df()
✨ جادوی زیر پوسته: سیستم برای هر ردیف، به زمان transaction_timestamp نگاه میکند و مقدار ویژگی را دقیقاً در آن لحظه بازسازی میکند.
🎯 گام ۵: استنتاج آنلاین (Online Inference)
# دریافت درخواست تراکنش
request = {
    "user_id": "12345",
    "merchant_id": "9876",
    "amount": 500
}

# بازیابی بردار ویژگی از Feature Store
online_features = fs.get_online_features(
    features=[
        "user_transaction_stats:transaction_count_10m",
        "merchant_credit_score:credit_rating"
    ],
    entity_rows=[
        {"user_id": "12345", "merchant_id": "9876"}
    ]
).to_dict()

# ارسال به مدل
prediction = model.predict(online_features)
🟣 فصل پنجم: ملاحظات عملیاتی و چالشهای مقیاسدهی الگوهای Feature Store
⚡ ۵.۱. مدیریت تأخیر (Latency Management) در الگوهای Feature Store
در سیستمهای با فرکانس بالا یا Ad-Tech، تأخیر Feature Store باید زیر ۵ میلیثانیه باشد.
| استراتژی | توضیح |
|---|---|
| 🗂️ Caching | کش درونحافظهای برای Hot Features |
| 📦 Serialization | Protobuf/Avro به جای JSON |
📊 ۵.۲. نظارت بر رانش ویژگی (Feature Drift Monitoring) در الگوهای Feature Store
الگوهای Feature Store بهترین مکان برای تشخیص تغییرات در توزیع دادههاست.
راهکار: ماژول Data Quality که توزیع آماری ویژگیها در Online Store را با زمان آموزش مقایسه میکند.
هشدار: اگر میانگین «مبلغ تراکنش» ناگهان ۲۰٪ افزایش یافت، احتمالاً مشکلی وجود دارد.
🔒 ۵.۳. حاکمیت داده و امنیت (Governance) در الگوهای Feature Store
| جنبه | توضیح |
|---|---|
| 👤 RBAC | کنترل دسترسی نقشمحور |
| 🎭 PII Masking | هش یا رمزنگاری خودکار |
💰 ۵.۴. مدیریت هزینه در الگوهای Feature Store
| لایه | تکنولوژی | کاربرد |
|---|---|---|
| 🔥 Hot Tier | Redis | دسترسی ۲۴ ساعت اخیر |
| 🌤️ Warm Tier | ScyllaDB/DynamoDB | دسترسی کمتر |
مقاله داخلی ما با عنوان «مانیتورینگ مدلهای یادگیری ماشین» را مطالعه کنید.
🟤 فصل ششم: چشمانداز ابزارها و انتخاب تکنولوژی برای الگوهای Feature Store
📊 مقایسه مسیرهای پیادهسازی الگوهای Feature Store
| مسیر | ابزارها | مناسب برای |
|---|---|---|
| 🏗️ ساخت داخلی | Uber Michelangelo, Airbnb Zipline | غولهای تکنولوژی |
| 📦 متنباز | Feast, Hopsworks | اکثر سازمانها |
| ☁️ مدیریت شده | Tecton, AWS Feature Store, Vertex AI | سازمانهای ابری |
📊 جدول مقایسه ابزارهای الگوهای Feature Store
| ابزار | تمرکز | مزایا | معایب |
|---|---|---|---|
| 🍽️ Feast | Serving و اتصال داده | سبک، قابل تنظیم | محاسبه ویژگی خارجی |
| 🏗️ Hopsworks | پلتفرم کامل | Training + Serving قوی | پیچیدگی بیشتر |
| ☁️ Tecton | سازمانی | مدیریت کامل چرخه حیات | هزینه بالا |
برای مطالعه مقایسه کامل ابزارهای Feature Store، مستندات Hopsworks را ببینید.
✅ نتیجهگیری: چکلیست نهایی الگوهای Feature Store
پیادهسازی الگوهای Feature Store در مقیاس سازمانی، سرمایهگذاری روی بهرهوری و قابلیت اطمینان است. این سیستم با حذف دوبارهکاری در مهندسی ویژگی، کاهش زمان رسیدن به بازار (Time-to-Market) مدلها و تضمین صحت دادهها، بلوغ هوش مصنوعی سازمان را از سطح آزمایشگاهی به سطح صنعتی ارتقا میدهد.
📌 الگوهای کلیدی که باید به خاطر سپرد
| الگو | توضیح |
|---|---|
| 💾 معماری دوگانه | Online/Offline برای تعادل سرعت و حجم |
| 🕰️ Point-in-Time Correctness | جلوگیری از نشت داده |
| 📝 Feature as Code | رجیستری متمرکز برای تعریف ویژگیها |
💡 پیام نهایی: موفقیت در این مسیر نیازمند تغییر فرهنگ سازمانی است تا تیمهای داده و تیمهای علم داده زبان مشترکی پیدا کنند؛ زبانی که الگوهای Feature Store آن را ترجمه میکنند.


